# Swin2SR
## Resumen
El modelo Swin2SR fue propuesto en [Swin2SR: SwinV2 Transformer for Compressed Image Super-Resolution and Restoration](https://huggingface.co/papers/2209.11345) por Marcos V. Conde, Ui-Jin Choi, Maxime Burchi y Radu Timofte. Swin2SR mejora el modelo [SwinIR](https://github.com/JingyunLiang/SwinIR/) incorporando capas de [Swin Transformer v2](swinv2), lo que mitiga problemas como la inestabilidad del entrenamiento, las diferencias de resolución entre el preentrenamiento y el ajuste fino, y la necesidad de grandes cantidades de datos.
El resumen del artículo es el siguiente:
*La compresión desempeña un papel importante en la transmisión y el almacenamiento eficientes de imágenes y vídeos a través de sistemas con ancho de banda limitado, como los servicios de streaming, la realidad virtual o los videojuegos. Sin embargo, la compresión inevitablemente genera artefactos y la pérdida de la información original, lo que puede degradar gravemente la calidad visual. Por estas razones, la mejora de la calidad de las imágenes comprimidas se ha convertido en un tema de investigación popular. Si bien la mayoría de los métodos de restauración de imágenes más avanzados se basan en redes neuronales convolucionales, otros métodos basados en transformers, como SwinIR, muestran un rendimiento impresionante en estas tareas. En este artículo, exploramos el novedoso Swin Transformer V2 para mejorar SwinIR en la superresolución de imágenes y, en particular, en el escenario de entrada comprimida. Con este método podemos abordar los principales problemas en el entrenamiento de modelos de visión basados en transformers, como la inestabilidad del entrenamiento, las diferencias de resolución entre el preentrenamiento y el ajuste fino, y la necesidad de grandes cantidades de datos. Realizamos experimentos en tres tareas representativas: eliminación de artefactos de compresión JPEG, superresolución de imágenes (clásica y ligera) y superresolución de imágenes comprimidas. Los resultados experimentales demuestran que nuestro método, Swin2SR, puede mejorar la convergencia del entrenamiento y el rendimiento de SwinIR, y es una de las cinco mejores soluciones en el "AIM 2022 Challenge on Super-Resolution of Compressed Image and Video".*
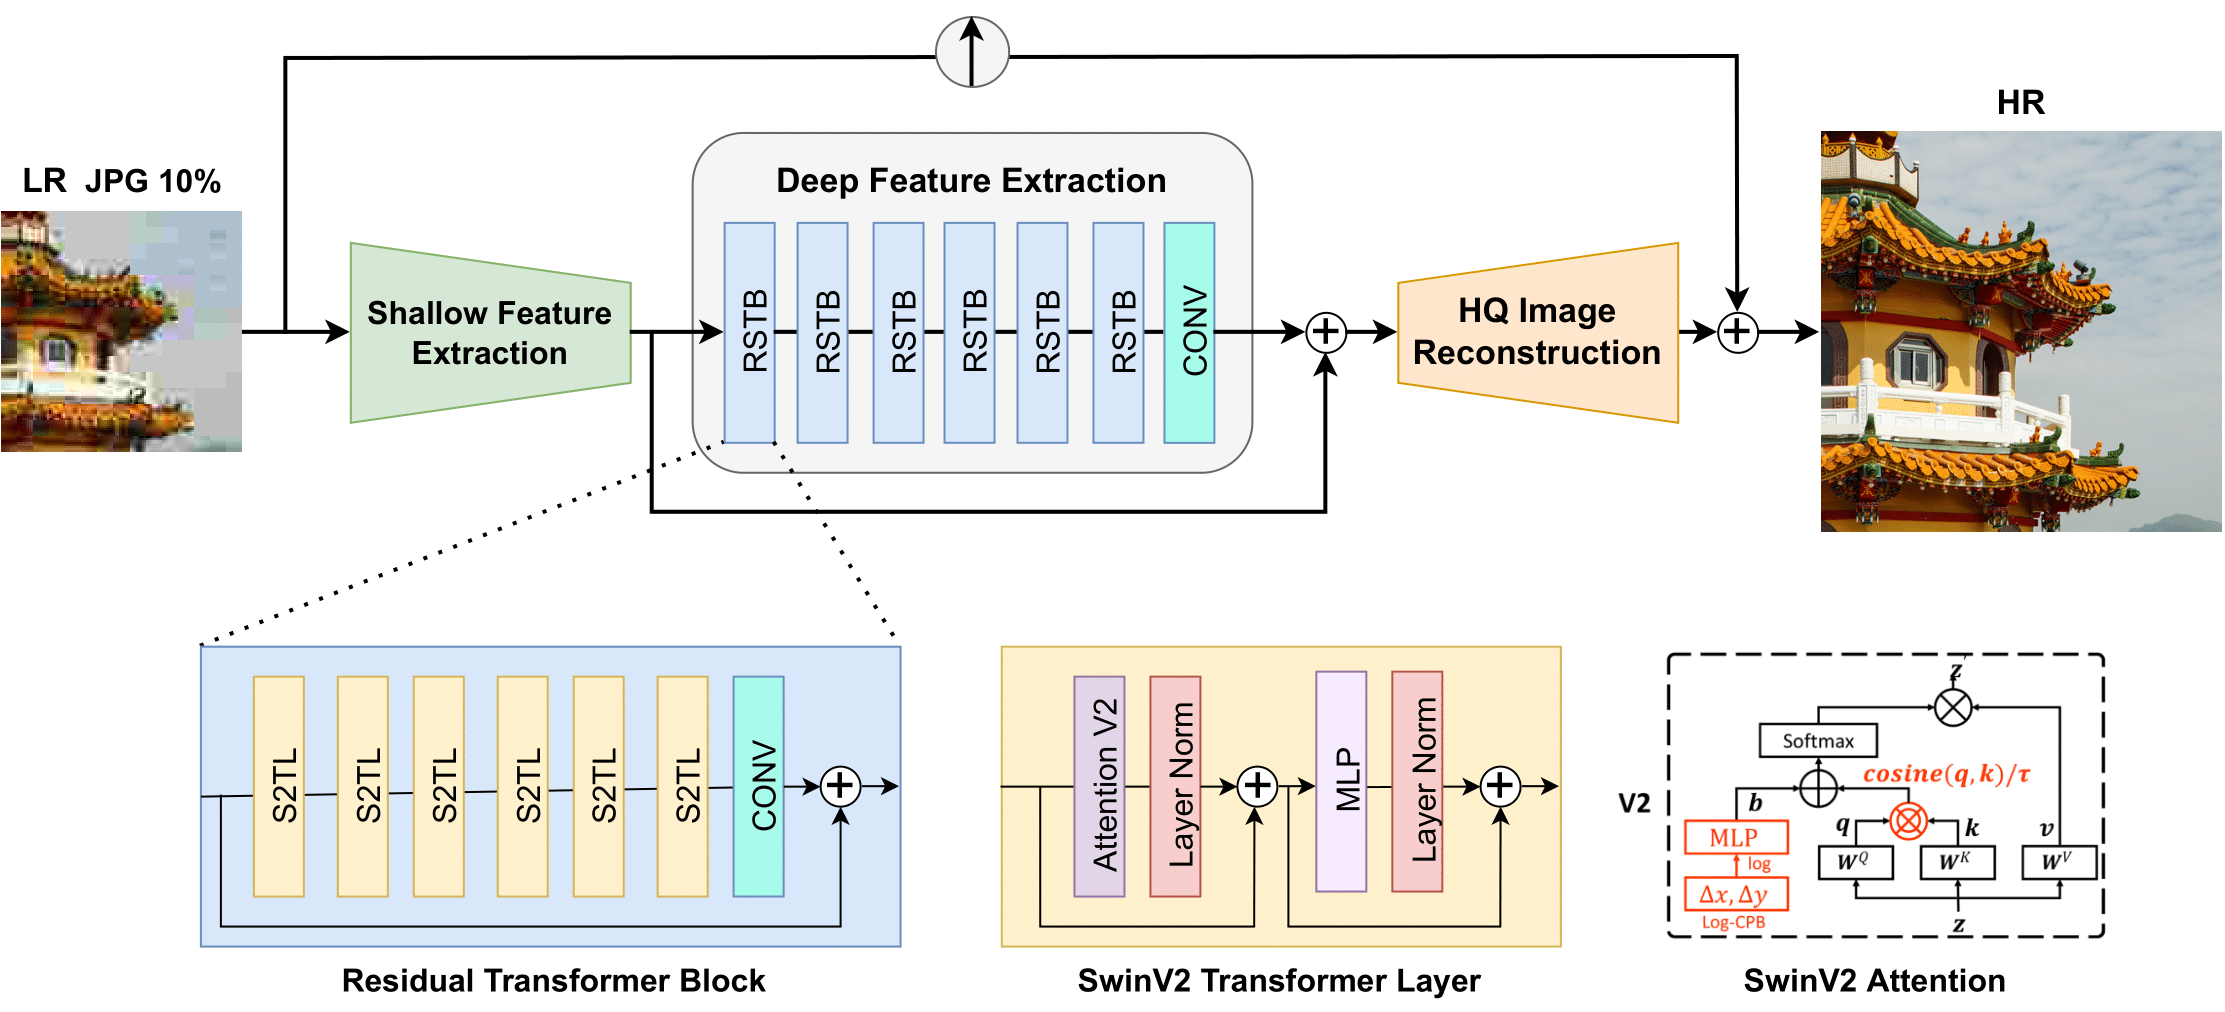 Arquitectura de Swin2SR. Tomada del artículo original.
Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr). El código original se puede encontrar [aquí](https://github.com/mv-lab/swin2sr).
## Recursos
Los cuadernos de demostración de Swin2SR se pueden encontrar [aquí](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Swin2SR).
Se puede encontrar un Space de demostración para super-resolución de imágenes con SwinSR [aquí](https://huggingface.co/spaces/jjourney1125/swin2sr).
## Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
#### transformers.Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
```python
transformers.Swin2SRImageProcessor(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_swin2sr.py#L41)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando el tamaño es un entero.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
size_divisor (`int`, *kwargs*, *opcional*, valor predeterminado `self.size_divisor`) : El tamaño al que se debe hacer divisible la altura y el ancho al aplicar relleno.
Construye un procesador de imágenes Swin2SRImageProcessor.
#### preprocess[[transformers.Swin2SRImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_swin2sr.py#L58)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
size_divisor (`int`, *kwargs*, *opcional*, valor predeterminado `self.size_divisor`) : El tamaño al que se debe hacer divisible la altura y el ancho al aplicar relleno.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
## Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
#### transformers.Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
```python
transformers.Swin2SRImageProcessorPil(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L42)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando el tamaño es un entero.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
size_divisor (`int`, *kwargs*, *opcional*, valor predeterminado `self.size_divisor`) : El tamaño al que se debe hacer divisible la altura y el ancho al aplicar relleno.
Construye un procesador de imágenes Swin2SRImageProcessor.
#### preprocess[[transformers.Swin2SRImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L59)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
size_divisor (`int`, *kwargs*, *opcional*, valor predeterminado `self.size_divisor`) : El tamaño al que se debe hacer divisible la altura y el ancho al aplicar relleno.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
## Swin2SRConfig[[transformers.Swin2SRConfig]]
#### transformers.Swin2SRConfig[[transformers.Swin2SRConfig]]
```python
transformers.Swin2SRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 64, patch_size: int | list[int] | tuple[int, int] = 1, num_channels: int = 3, num_channels_out: int | None = None, embed_dim: int = 180, depths: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), num_heads: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), window_size: int = 8, mlp_ratio: float = 2.0, qkv_bias: bool = True, hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, drop_path_rate: float | int = 0.1, hidden_act: str = 'gelu', use_absolute_embeddings: bool = False, initializer_range: float = 0.02, layer_norm_eps: float = 1e-05, upscale: int = 2, img_range: float = 1.0, resi_connection: str = '1conv', upsampler: str = 'pixelshuffle')
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/configuration_swin2sr.py#L24)
**Parámetros:**
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `64`) : El tamaño (resolución) de cada imagen.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `1`) : El tamaño (resolución) de cada parche.
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
num_channels_out (`int`, *opcional*, valor predeterminado `num_channels`) : El número de canales de salida. Si no se establece, se fijará en `num_channels`.
embed_dim (`int`, *opcional*, valor predeterminado `180`) : Dimensionalidad de los embeddings y los estados ocultos.
depths (`list(int)`, *opcional*, valor predeterminado `[6, 6, 6, 6, 6, 6]`) : Profundidad de cada capa en el codificador Transformer.
num_heads (`list(int)`, *opcional*, valor predeterminado `[6, 6, 6, 6, 6, 6]`) : Número de cabezas de atención en cada capa del codificador Transformer.
window_size (`int`, *opcional*, valor predeterminado 8) : Tamaño de las ventanas.
mlp_ratio (`float`, *opcional*, valor predeterminado `2.0`) : Proporción entre la dimensión oculta del MLP y la dimensión de incrustación.
qkv_bias (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe añadir un sesgo a las consultas, claves y valores.
hidden_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La probabilidad de dropout para todas las capas completamente conectadas en los embeddings, el codificador y el pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
drop_path_rate (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : Tasa de drop path para la fusión de parches.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
use_absolute_embeddings (`bool`, *opcional*, valor predeterminado `False`) : Si se deben usar incrustaciones de posición absoluta.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
upscale (`int`, *opcional*, valor predeterminado 2) : El factor de ampliación de la imagen. 2/3/4/8 para superresolución de imagen, 1 para reducción de ruido y de artefactos de compresión
img_range (`float`, *opcional*, valor predeterminado 1.0) : El rango de los valores de la imagen de entrada.
resi_connection (`str`, *opcional*, valor predeterminado `"1conv"`) : El bloque convolucional que se utiliza antes de la conexión residual en cada etapa.
upsampler (`str`, *opcional*, valor predeterminado `"pixelshuffle"`) : El módulo de reconstrucción. Puede ser 'pixelshuffle'/'pixelshuffledirect'/'nearest+conv'/None.
Esta es la clase de configuración para almacenar la configuración de un Swin2SRModel. Se utiliza para instanciar un modelo Swin2Sr según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [caidas/swin2sr-classicalsr-x2-64](https://huggingface.co/caidas/swin2sr-classicalsr-x2-64)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import Swin2SRConfig, Swin2SRModel
>>> # Initializing a Swin2SR caidas/swin2sr-classicalsr-x2-64 style configuration
>>> configuration = Swin2SRConfig()
>>> # Initializing a model (with random weights) from the caidas/swin2sr-classicalsr-x2-64 style configuration
>>> model = Swin2SRModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Swin2SRModel[[transformers.Swin2SRModel]]
#### transformers.Swin2SRModel[[transformers.Swin2SRModel]]
```python
transformers.Swin2SRModel(config: Swin2SRConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L710)
**Parámetros:**
config ([Swin2SRConfig](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Swin2Sr sin procesar, que genera estados ocultos crudos sin ninguna cabeza específica en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.Swin2SRModel.forward]]
```python
forward(pixel_values: Tensor, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L752)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [Swin2SRImageProcessor](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRImageProcessor). Consulte [Swin2SRImageProcessor.__call__()](/docs/transformers/main/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles (`processor_class` usa [Swin2SRImageProcessor](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRImageProcessor) para procesar las imágenes).
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/main/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [BaseModelOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.BaseModelOutput) o `tuple(torch.Tensor)`
Un [BaseModelOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.BaseModelOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([Swin2SRConfig](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRConfig)) y las entradas.
El método forward de [Swin2SRModel](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
```python
```
## Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
#### transformers.Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
```python
transformers.Swin2SRForImageSuperResolution(config: Swin2SRConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L943)
**Parámetros:**
config ([Swin2SRConfig](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Transformador del modelo Swin2SR con una cabeza de amplificador en la parte superior para la superresolución y restauración de imágenes.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.Swin2SRForImageSuperResolution.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L970)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [Swin2SRImageProcessor](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRImageProcessor). Consulte [Swin2SRImageProcessor.__call__()](/docs/transformers/main/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles (`processor_class` usa [Swin2SRImageProcessor](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRImageProcessor) para procesar las imágenes).
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Etiquetas para calcular la pérdida de modelado de lenguaje enmascarado. Los índices deben estar en `[0, ..., config.vocab_size]` o ser -100 (consulte la docstring de `input_ids`). Los tokens con índices fijados en `-100` se ignoran (se enmascaran); la pérdida solo se calcula para los tokens con etiquetas en `[0, ..., config.vocab_size]`.
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/main/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** `ImageSuperResolutionOutput` o `tuple(torch.Tensor)`
Un `ImageSuperResolutionOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([Swin2SRConfig](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRConfig)) y las entradas.
El método forward de [Swin2SRForImageSuperResolution](/docs/transformers/main/es/model_doc/swin2sr#transformers.Swin2SRForImageSuperResolution) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, devuelta cuando se proporciona `labels`) -- Pérdida de reconstrucción.
- **reconstrucción** (`torch.Tensor` de forma `(batch_size, num_channels, height, width)`) -- Imágenes reconstruidas, posiblemente ampliadas.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, devuelto cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada etapa) de forma `(batch_size, sequence_length, hidden_size)`. Hidden-states (también llamados feature maps) del modelo en la salida de cada etapa.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, patch_size, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
```python
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>> from io import BytesIO
>>> from transformers import AutoImageProcessor, Swin2SRForImageSuperResolution
>>> processor = AutoImageProcessor.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> model = Swin2SRForImageSuperResolution.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> url = "https://huggingface.co/spaces/jjourney1125/swin2sr/resolve/main/samples/butterfly.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # prepare image for the model
>>> inputs = processor(image, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> output = outputs.reconstruction.data.squeeze().float().cpu().clamp_(0, 1).numpy()
>>> output = np.moveaxis(output, source=0, destination=-1)
>>> output = (output * 255.0).round().astype(np.uint8) # float32 to uint8
>>> # you can visualize `output` with `Image.fromarray`
```