# LeViT
## 概要
LeViTモデルは、Ben Graham、Alaaeldin El-Nouby、Hugo Touvron、Pierre Stock、Armand Joulin、Hervé Jégou、Matthijs Douze による [LeViT: Introducing Convolutions to Vision Transformers](https://huggingface.co/papers/2104.01136) で提案されました。LeViTは、Transformerにおける解像度が段階的に低下する活性化マップや、位置情報を統合するためのアテンションバイアスの導入といったいくつかのアーキテクチャ上の違いにより、[Vision Transformer (ViT)](vit) の性能と効率を向上させます。
論文の抄録は以下の通りです。
*高速な処理環境において、精度と効率のトレードオフを最適化する画像分類アーキテクチャのファミリーを設計しました。本研究では、並列処理に優れたハードウェア上で競争力を持つアテンションベースのアーキテクチャに関する最近の知見を活用しています。また、膨大な畳み込みニューラルネットワークの文献にある原理を再検討し、特に解像度が段階的に低下する活性化マップをトランスフォーマーに適用しています。さらに、ビジョントランスフォーマーにおける位置情報の統合方法として、アテンションバイアスという新しい手法を導入しました。その結果、高速推論による画像分類のためのハイブリッドニューラルネットワークであるLeViTを提案します。幅広いアプリケーションシナリオをより正確に反映できるよう、異なるハードウェアプラットフォームにおける効率の異なる指標を検討しています。広範な実験により、当社の技術的選択が実証的に検証され、ほとんどのアーキテクチャに適していることが示されました。全体として、LeViTは、速度と精度のトレードオフにおいて、既存の畳み込みネットワークやビジョントランスフォーマーを大幅に上回ります。例えば、ImageNetのtop-1精度が80%の場合、LeViTはCPU上でEfficientNetの5倍の速度を実現しています。*
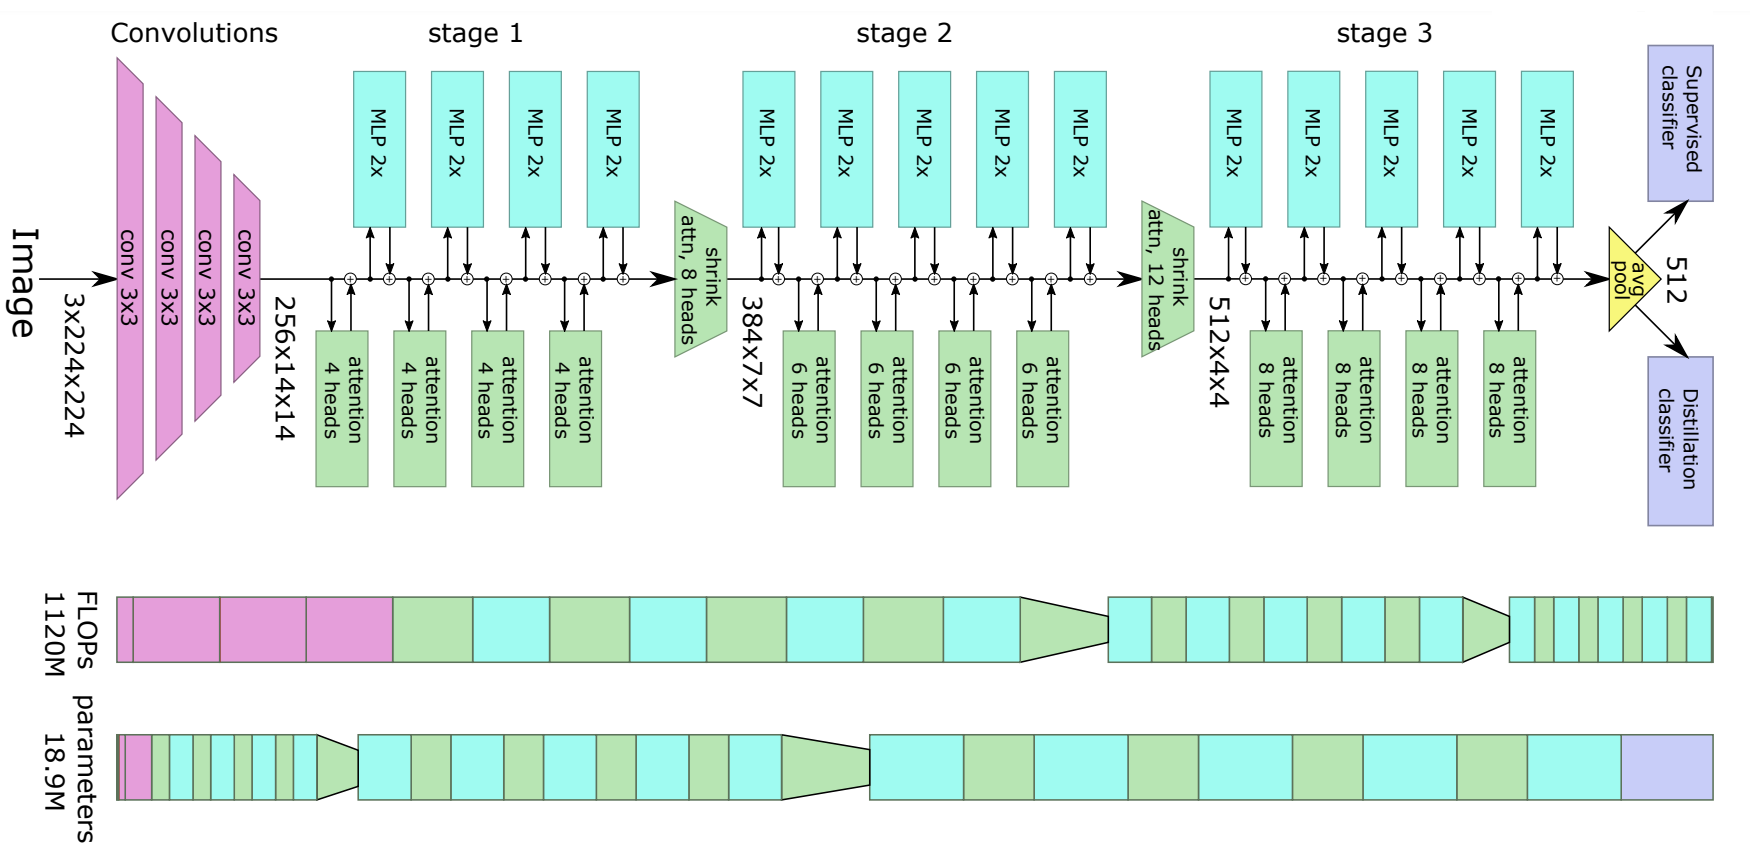 LeViTアーキテクチャ。元の論文より引用。
このモデルは[anugunj](https://huggingface.co/anugunj)によって提供されました。元のコードは[こちら](https://github.com/facebookresearch/LeViT)で確認できます。
## 使用のコツ
- ViTと比較して、LeViTモデルは、教師モデル(LeViT論文ではResNetのようなモデル)から効果的に学習するために、追加の蒸留ヘッドを使用します。この蒸留ヘッドは、ResNetのようなモデルの監督のもと、バックプロパゲーションによって学習されます。また、畳み込みニューラルネットワークから着想を得て、解像度が段階的に低下する活性化マップを使用することで、効率を向上させています。
- 蒸留済みモデルのファインチューニングには2つの方法があります。1つ目は、最終的な隠れ状態の上に予測ヘッドのみを配置し、蒸留ヘッドを使用しないという従来の方法です。もう1つは、最終的な隠れ状態の上に予測ヘッドと蒸留ヘッドの両方を配置する方法です。この場合、予測ヘッドはヘッドの予測と正解ラベル間の通常のクロスエントロピーで学習され、蒸留予測ヘッドはハード蒸留(蒸留ヘッドの予測と教師モデルが予測したラベル間のクロスエントロピー)で学習されます。推論時には、両方のヘッドの予測の平均を最終的な予測として採用します。(2)は「蒸留を用いたファインチューニング」とも呼ばれ、すでに下流データセットでファインチューニング済みの教師モデルに依存するためです。モデルとしては、(1)は[LevitForImageClassification](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassification)に対応し、(2)は[LevitForImageClassificationWithTeacher](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassificationWithTeacher)に対応します。
- 公開されているすべてのチェックポイントは、[ImageNet-1k](https://huggingface.co/datasets/ILSVRC/imagenet-1k)(ILSVRC 2012とも呼ばれ、130万枚の画像と1,000クラスからなるデータセット)のみで事前学習およびファインチューニングが行われました。外部データは使用されていません。これは、JFT-300MデータセットやImageNet-21kなどの外部データを用いて事前学習を行った元のViTモデルとは対照的です。
- LeViTの著者は5つの学習済みLeViTモデルを公開しており、これらは[LevitModel](/docs/transformers/main/ja/model_doc/levit#transformers.LevitModel)または[LevitForImageClassification](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassification)に直接組み込むことができます。データ拡張、最適化、正則化などの手法を用いることで、より大規模なデータセットでの学習をシミュレートしました(事前学習にはImageNet-1kのみを使用)。利用可能な5つのバリアントは以下の通りです(すべて224x224サイズの画像で学習済み): *facebook/levit-128S*、*facebook/levit-128*、*facebook/levit-192*、*facebook/levit-256*、*facebook/levit-384*。モデルに画像を渡す際は、[LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor)を使用して画像を準備する必要があります。
- [LevitForImageClassificationWithTeacher](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassificationWithTeacher) は、現在、推論のみをサポートしており、トレーニングやファインチューニングはサポートされていません。
- 推論およびカスタムデータでのファインチューニングに関するデモノートブックは、[こちら](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer)でご覧いただけます([ViTImageProcessor](/docs/transformers/main/ja/model_doc/vit#transformers.ViTImageProcessor)を[LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor)に、[ViTForImageClassification](/docs/transformers/main/ja/model_doc/vit#transformers.ViTForImageClassification)を[LevitForImageClassification](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassification)または[LevitForImageClassificationWithTeacher](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassificationWithTeacher)に置き換えるだけで対応できます)。
## リソース
LeViTの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソースのリストです。
- [LevitForImageClassification](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassification) は、この [ノートブック](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) でサポートされています。
- 関連項目: [画像分類タスクガイド](../tasks/image_classification)
ここにリソースを掲載していただくことを希望される場合は、Pull Request を開いてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しいものを示すことが望ましいです。
## LevitConfig[[transformers.LevitConfig]]
#### transformers.LevitConfig[[transformers.LevitConfig]]
```python
transformers.LevitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 224, num_channels: int = 3, kernel_size: int = 3, stride: int = 2, padding: int = 1, patch_size: int | list[int] | tuple[int, int] = 16, hidden_sizes: list[int] | tuple[int, ...] = (128, 256, 384), num_attention_heads: list[int] | tuple[int, ...] = (4, 8, 12), depths: list[int] | tuple[int, ...] = (4, 4, 4), key_dim: list[int] | tuple[int, ...] = (16, 16, 16), drop_path_rate: int = 0, mlp_ratio: list[int] | tuple[int, ...] = (2, 2, 2), attention_ratio: list[int] | tuple[int, ...] = (2, 2, 2), initializer_range: float = 0.02)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/configuration_levit.py#L24)
**パラメータ:**
image_size (`Union[int, list[int], tuple[int, int]]`、*任意*、デフォルトは`224`) : 各画像のサイズ(解像度)。
num_channels (`int`、*任意*、デフォルトは`3`) : 入力チャネル数。
kernel_size (`int`、*任意*、デフォルトは`3`) : 畳み込みカーネルのサイズ。
stride (`int`、*optional*、デフォルトは 2) : パッチ埋め込みの初期畳み込み層のストライドサイズです。
padding (`int`、*optional*、デフォルトは 1) : patch embedding の初期畳み込み層の padding サイズです。
patch_size (`Union[int, list[int], tuple[int, int]]`、*任意*、デフォルトは`16`) : 各パッチのサイズ(解像度)。
hidden_sizes (`Union[list[int], tuple[int, ...]]`、*任意*、デフォルトは`(128, 256, 384)`) : モデルの各ステージにおける次元数(隠れ層サイズ)。
num_attention_heads (`Union[list[int], tuple[int, ...]]`、*任意*、デフォルトは`(4, 8, 12)`) : Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。
depths (`Union[list[int], tuple[int, ...]]`、*任意*、デフォルトは`(4, 4, 4)`) : Transformer の各層の深さ。
key_dim (`list[int]`、*任意*、デフォルトは`[16, 16, 16]`) : エンコーダーブロックにおける各キーのサイズ。
drop_path_rate (`int`、*任意*、デフォルトは`0`) : パッチ融合のドロップパス率です。
mlp_ratio (`Union[list[int], tuple[int, ...]]`、*任意*、デフォルトは`(2, 2, 2)`) : MLPの隠れ層次元と埋め込み次元の比率。
attention_ratio (`list[int]`、*optional*、デフォルトは`[2, 2, 2]`) : attention層の入力次元に対する出力次元の比率。
initializer_range (`float`、*任意*、デフォルトは`0.02`) : すべての重み行列を初期化するためのtruncated_normal_initializerの標準偏差です。
これはLevitModelの設定を保存するための設定クラスです。指定された引数に基づいてLevitモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、[facebook/levit-128S](https://huggingface.co/facebook/levit-128S)と類似した設定が得られます。
設定オブジェクトは [PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) を継承し、モデルの出力を制御するために使用できます。詳細については、[PreTrainedConfig](/docs/transformers/main/ja/main_classes/configuration#transformers.PreTrainedConfig) のドキュメントを参照してください。
例:
```python
>>> from transformers import LevitConfig, LevitModel
>>> # Initializing a LeViT levit-128S style configuration
>>> configuration = LevitConfig()
>>> # Initializing a model (with random weights) from the levit-128S style configuration
>>> model = LevitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LevitImageProcessor[[transformers.LevitImageProcessor]]
#### transformers.LevitImageProcessor[[transformers.LevitImageProcessor]]
```python
transformers.LevitImageProcessor(**kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/image_processing_levit.py#L33)
**パラメータ:**
do_convert_rgb (`bool`, *kwargs*, *任意*, デフォルトは `None`) : 画像を RGB に変換するかどうかを指定します。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'shortest_edge' : 224}`): モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*, デフォルトは `False`) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'height' : 224, 'width': 224}`): `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルトは `3`) : 画像をリサイズする場合に使用するリサンプリングフィルター。`PILImageResampling` の列挙型のいずれかになります。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.485, 0.456, 0.406]`) : 正規化に使用する画像の平均値です。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.229, 0.224, 0.225]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
LevitImageProcessorの画像プロセッサを構築します。
#### preprocess[[transformers.LevitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
image_like_kwargs (`dict[str, Any]`、*省略可*) : 追加の画像類似の入力も前処理対象にするための開発者向けフラグです。引数として kwarg を渡す方法が機能しない場合のみ使用してください。例えば、`preprocess(images, masks=masks)` が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりに `preprocess(images, image_like_inputs={"masks": masks})` を使用できます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
## LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
#### transformers.LevitImageProcessorPil[[transformers.LevitImageProcessorPil]]
```python
transformers.LevitImageProcessorPil(**kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/image_processing_pil_levit.py#L32)
**パラメータ:**
do_convert_rgb (`bool`, *kwargs*, *任意*, デフォルトは `None`) : 画像を RGB に変換するかどうかを指定します。
do_resize (`bool`, *kwargs*, *任意*, デフォルトは `True`) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'shortest_edge' : 224}`): モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*, デフォルトは `False`) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*、デフォルト値は `{'height' : 224, 'width': 224}`): `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*、デフォルトは `3`) : 画像をリサイズする場合に使用するリサンプリングフィルター。`PILImageResampling` の列挙型のいずれかになります。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*, デフォルトは `0.00392156862745098`) : `do_rescale` が `True` に設定されている場合、画像をリスケールするための係数。
do_normalize (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.485, 0.456, 0.406]`) : 正規化に使用する画像の平均値です。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, デフォルトは `[0.229, 0.224, 0.225]`) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*, デフォルトは `True`) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
LevitImageProcessorの画像プロセッサを構築します。
#### preprocess[[transformers.LevitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**パラメータ:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 前処理対象の画像。ピクセル値が 0 から 255 の範囲にある単一の画像またはバッチの画像を想定しています。ピクセル値が 0 から 1 の範囲にある画像を渡す場合は、`do_rescale=False` を設定してください。
image_like_kwargs (`dict[str, Any]`、*省略可*) : 追加の画像類似の入力も前処理対象にするための開発者向けフラグです。引数として kwarg を渡す方法が機能しない場合のみ使用してください。例えば、`preprocess(images, masks=masks)` が推奨される方法ですが、一部のモデルでは引数の優先順位の問題が発生します。そのような場合は、代わりに `preprocess(images, image_like_inputs={"masks": masks})` を使用できます。
do_convert_rgb (`bool`, *kwargs*, *optional*) : 画像を RGB に変換するかどうか。
do_resize (`bool`, *kwargs*, *optional*) : 画像をリサイズするかどうか。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : モデルへの最大入力次元を記述します。
default_to_square (`bool`, *kwargs*, *optional*) : size が int の場合、リサイズ時に正方形の画像をデフォルトとするかどうか。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` を適用した後の出力画像のサイズ。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 画像をリサイズする場合に使用するリサンプリングフィルタ。`PILImageResampling` の列挙型のいずれかです。`do_resize` が `True` に設定されている場合のみ有効です。
do_rescale (`bool`, *kwargs*, *任意*) : 画像をリスケールするかどうか。
rescale_factor (`float`, *kwargs*, *optional*) : `do_rescale` が `True` に設定されている場合、画像をリサイズするためのリスケール係数。
do_normalize (`bool`, *kwargs*, *optional*) : 画像を正規化するかどうかを指定します。
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の平均値。`do_normalize` が `True` に設定されている場合のみ有効です。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : 正規化に使用する画像の標準偏差。`do_normalize` が `True` に設定されている場合のみ有効です。
do_pad (`bool`, *kwargs*, *任意*) : 画像にパディングを適用するかどうか。パディングは、バッチ内の最大サイズに合わせるか、画像ごとに固定の正方形サイズに合わせるかのいずれかで行われます。正確なパディング戦略はモデルによって異なります。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 画像をパディングするサイズを`{"height": int, "width" int}`で指定します。前処理に提供されたすべての画像サイズより大きい必要があります。`pad_size`が指定されない場合、バッチ内の最大の幅と高さにパディングされます。`do_pad=True.`の場合にのみ適用されます。
do_center_crop (`bool`, *kwargs*, *optional*) : 画像を中央クロップするかどうか。
data_format (`Union[str, ~image_utils.ChannelDimension]`、*kwargs*、*optional*) : 対応するのは `ChannelDimension.FIRST` のみです。slow processors との互換性のために追加されました。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *任意*) : 入力画像のチャネル次元の形式です。設定されていない場合、入力画像からチャネル次元の形式が推論されます。以下のいずれかになります: - `"channels_first"` または `ChannelDimension.FIRST`: (num_channels, height, width) 形式の画像。 - `"channels_last"` または `ChannelDimension.LAST`: (height, width, num_channels) 形式の画像。 - `"none"` または `ChannelDimension.NONE`: (height, width) 形式の画像。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 動画を処理するデバイスです。未設定の場合、入力動画からデバイスが推論されます。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`に設定されている場合はスタックされたテンソルを返し、それ以外の場合はテンソルのリストを返します。
disable_grouping (`bool`, *kwargs*, *optional*) : 画像をサイズごとにグループ化してバッチ処理するのではなく、個別に処理するためにグループ化を無効にするかどうかを指定します。None の場合、画像が CPU にある場合は True、それ以外の場合は False に設定されます。この選択は、https://github.com/huggingface/transformers/pull/38157 に詳しく記載されている実証的な観察に基づいています。
image_seq_length (`int`, *kwargs*, *任意*) : 入力内の各画像に使用される画像トークンの数です。後方互換性のために追加されましたが、将来のモデルではプロセッサの属性として設定されるべきです。
**戻り値:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ メソッドによって返されるリスト/配列/テンソルの辞書('pixel_values' など)。
- **tensor_type** (`Union[None, str, TensorType]`、*省略可*) -- 初期化時に PyTorch/Numpy の Tensor 内の整数リストを変換するために、ここで tensor_type を指定できます。
画像または画像のバッチを前処理します。
## LevitModel[[transformers.LevitModel]]
#### transformers.LevitModel[[transformers.LevitModel]]
```python
transformers.LevitModel(config: LevitConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L489)
**パラメータ:**
config ([LevitConfig](/docs/transformers/main/ja/model_doc/levit#transformers.LevitConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを参照してください。
特定のヘッドを付加せず、生のhidden-statesを出力する素のLevit Model。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.LevitModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L498)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor) を使用して取得できます。詳細については [LevitImageProcessor.__call__()](/docs/transformers/main/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください(`processor_class` は画像の処理に [LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor) を使用します)。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/main/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** `BaseModelOutputWithPoolingAndNoAttention` または `tuple(torch.Tensor)`
`BaseModelOutputWithPoolingAndNoAttention`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([LevitConfig](/docs/transformers/main/ja/model_doc/levit#transformers.LevitConfig))と入力に応じて、さまざまな要素で構成されます。
[LevitModel](/docs/transformers/main/ja/model_doc/levit#transformers.LevitModel)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **last_hidden_state** (`torch.Tensor`、形状 `(batch_size, num_channels, height, width)`) -- モデルの最終層の出力における隠れ状態のシーケンス。
- **pooler_output** (`torch.Tensor`、形状 `(batch_size, hidden_size)`) -- 空間次元に対するプーリング操作を行った後の最終層の隠れ状態。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(埋め込み層を持つモデルの場合、埋め込みの出力用 1 つ + 各層の出力用 1 つ)で、形状は `(batch_size, num_channels, height, width)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
例:
```python
```
## LevitForImageClassification[[transformers.LevitForImageClassification]]
#### transformers.LevitForImageClassification[[transformers.LevitForImageClassification]]
```python
transformers.LevitForImageClassification(config: LevitConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L542)
**パラメータ:**
config ([LevitConfig](/docs/transformers/main/ja/model_doc/levit#transformers.LevitConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを参照してください。
Levitモデルの画像分類ヘッド付き(プーリングされた特徴量の上位に線形層を配置)、例えばImageNet用。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.LevitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L559)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor) を使用して取得できます。詳細については [LevitImageProcessor.__call__()](/docs/transformers/main/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください(`processor_class` は画像の処理に [LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor) を使用します)。
labels (`torch.LongTensor`、shape `(batch_size,)`、*任意*) : 画像分類/回帰の損失を計算するためのラベル。インデックスは `[0, ..., config.num_labels - 1]` の範囲である必要があります。`config.num_labels == 1` の場合は回帰損失(Mean-Square loss)が計算され、`config.num_labels > 1` の場合は分類損失(Cross-Entropy)が計算されます。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/main/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** [ImageClassifierOutputWithNoAttention](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) または `tuple(torch.Tensor)`
設定([LevitConfig](/docs/transformers/main/ja/model_doc/levit#transformers.LevitConfig))と入力に応じて、さまざまな要素で構成される、[ImageClassifierOutputWithNoAttention](/docs/transformers/main/ja/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) または `torch.Tensor` のタプル(`return_dict=False` が渡された場合、または `config.return_dict=False` の場合)。
[LevitForImageClassification](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassification)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **loss** (`torch.Tensor`、shape `(1,)`、*optional*、`labels` が指定された場合に返されます) -- 分類損失(config.num_labels==1 の場合は回帰損失)。
- **logits** (`torch.Tensor`、形状 `(batch_size, config.num_labels)`) -- SoftMax 適用前の分類(または config.num_labels==1 の場合は回帰)スコア。
- **hidden_states** (`tuple(torch.Tensor)`、*optional*、`output_hidden_states=True` が渡された場合、または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各ステージの出力用 1 つずつ)で、形状は `(batch_size, num_channels, height, width)` です。各ステージの出力におけるモデルの隠れ状態(特徴マップとも呼ばれます)。
例:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassification.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
#### transformers.LevitForImageClassificationWithTeacher[[transformers.LevitForImageClassificationWithTeacher]]
```python
transformers.LevitForImageClassificationWithTeacher(config: LevitConfig)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L599)
**パラメータ:**
config ([LevitConfig](/docs/transformers/main/ja/model_doc/levit#transformers.LevitConfig)) : モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、[from_pretrained()](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel.from_pretrained) メソッドを参照してください。
LeViT Model 画像分類ヘッドを上部に備えた transformer(最終隠れ状態の上に線形層、蒸留トークンの最終隠れ状態の上に線形層)を備えたモデル。ImageNet などに対応。 .. warning:: このモデルは推論のみをサポートしています。蒸留(つまり教師モデルを使用する)によるファインチューニングはまだサポートされていません。
このモデルは [PreTrainedModel](/docs/transformers/main/ja/main_classes/model#transformers.PreTrainedModel) を継承しています。ライブラリがすべてのモデルに対して実装している汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchの[torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)のサブクラスでもあります。通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
#### forward[[transformers.LevitForImageClassificationWithTeacher.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[ソース](https://github.com/huggingface/transformers/blob/main/src/transformers/models/levit/modeling_levit.py#L621)
**パラメータ:**
pixel_values (`torch.Tensor`、形状 `(batch_size, num_channels, image_size, image_size)`、*任意*) : 入力画像に対応するテンソルです。ピクセル値は [LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor) を使用して取得できます。詳細については [LevitImageProcessor.__call__()](/docs/transformers/main/ja/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) を参照してください(`processor_class` は画像の処理に [LevitImageProcessor](/docs/transformers/main/ja/model_doc/levit#transformers.LevitImageProcessor) を使用します)。
output_hidden_states (`bool`, *任意*) : 全レイヤーの hidden states を返すかどうかを指定します。詳細は、返されるテンソルの `hidden_states` を参照してください。
return_dict (`bool`, *任意*) : プレーンなタプルではなく [ModelOutput](/docs/transformers/main/ja/main_classes/output#transformers.utils.ModelOutput) を返すかどうか。
**戻り値:** `LevitForImageClassificationWithTeacherOutput` または `tuple(torch.Tensor)`
`LevitForImageClassificationWithTeacherOutput`、または`torch.Tensor`のタプル(`return_dict=False`が渡された場合、または`config.return_dict=False`の場合)。設定([LevitConfig](/docs/transformers/main/ja/model_doc/levit#transformers.LevitConfig))と入力に応じて、さまざまな要素で構成されます。
[LevitForImageClassificationWithTeacher](/docs/transformers/main/ja/model_doc/levit#transformers.LevitForImageClassificationWithTeacher)のforwardメソッドは、`__call__`特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく`Module`インスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを無視してしまいます。
- **logits** (`torch.Tensor`、形状 `(batch_size, config.num_labels)`) -- `cls_logits` と `distillation_logits` の平均値として得られる予測スコア。
- **cls_logits** (`torch.Tensor`、shape `(batch_size, config.num_labels)`) -- 分類ヘッド(クラストークンの最終的な隠れ状態の上に置かれた線形層)の予測スコアです。
- **distillation_logits** (`torch.Tensor`、形状 `(batch_size, config.num_labels)`) -- ディスティレーションヘッドの予測スコア(つまり、ディスティレーショントークンの最終隠れ状態の上に置かれた線形層の出力)。
- **hidden_states** (`tuple[torch.Tensor]`、*optional*、`output_hidden_states=True` が渡された場合、または `config.output_hidden_states=True` の場合に返されます) -- `torch.Tensor` のタプル(モデルに埋め込み層がある場合はその出力用 1 つ、各層の出力用 1 つずつ)で、形状は `(batch_size, sequence_length, hidden_size)` です。
各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
例:
```python
>>> from transformers import AutoImageProcessor, LevitForImageClassificationWithTeacher
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/levit-128S")
>>> model = LevitForImageClassificationWithTeacher.from_pretrained("facebook/levit-128S")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```