# LLaVa
## Aperçu
LLaVa est un chatbot open source entraîné par fine-tuning de LlamA/Vicuna sur des données multimodales générées par GPT pour le suivi d'instructions. Il s'agit d'un modèle de langage auto-régressif, basé sur l'architecture transformer. En d'autres termes, c'est une version multimodale des LLM fine-tunés pour le chat / les instructions.
Le modèle LLaVa a été proposé dans [Visual Instruction Tuning](https://huggingface.co/papers/2304.08485) et amélioré dans [Improved Baselines with Visual Instruction Tuning](https://huggingface.co/papers/2310.03744) par Haotian Liu, Chunyuan Li, Yuheng Li et Yong Jae Lee.
L'abstract de l'article est le suivant :
*Les grands modèles multimodaux (LMM) ont récemment montré des progrès encourageants grâce à l’ajustement d’instructions visuelles. Dans cette note, nous montrons que le connecteur intermodal vision-langage entièrement connecté de LLaVA est surprenamment puissant et efficace en données. Avec de simples modifications de LLaVA, à savoir l’utilisation de CLIP-ViT-L-336px avec une projection MLP et l’ajout de données VQA orientées tâches académiques avec des prompts de formatage de réponse simples, nous établissons des lignes de base plus solides qui atteignent l’état de l’art sur 11 benchmarks. Notre point de contrôle final de 13B n’utilise que 1,2M de données publiquement disponibles et termine l’entraînement complet en ∼1 jour sur un seul nœud 8-A100. Nous espérons que cela rendra la recherche sur les LMM de l’état de l’art plus accessible. Le code et le modèle seront publiquement disponibles*
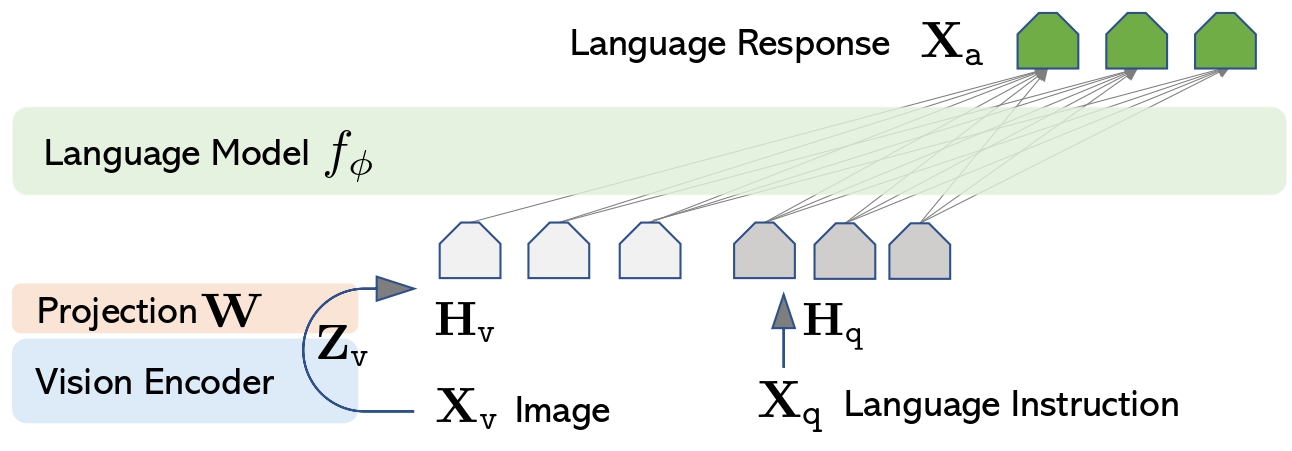 Architecture de LLaVa. Issue de l'article original.
Ce modèle a été contribué par [ArthurZ](https://huggingface.co/ArthurZ) et [ybelkada](https://huggingface.co/ybelkada). Le code d'origine est disponible [ici](https://github.com/haotian-liu/LLaVA/tree/main/llava).
> [!TIP]
> Définissez `use_kernels=True` dans [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour remplacer les couches prises en charge par des noyaux optimisés du Hub. Consultez [Chargement des noyaux](../kernel_doc/loading_kernels) pour en savoir plus.
## Conseils d'utilisation
- Nous recommandons aux utilisateurs d'utiliser `padding_side="left"` lors du calcul de la génération par lots, car cela conduit à des résultats plus précis. Assurez-vous simplement d'appeler `processor.tokenizer.padding_side = "left"` avant de générer.
- Notez que le modèle n'a pas été explicitement entraîné pour traiter plusieurs images dans le même prompt ; bien que cela soit techniquement possible, vous pouvez rencontrer des résultats imprécis.
> [!NOTE]
> Les modèles LLaVA publiés après la version v4.46 émettront des avertissements concernant l’ajout de `processor.patch_size = {{patch_size}}`, `processor.num_additional_image_tokens = {{num_additional_image_tokens}}` et `processor.vision_feature_select_strategy = {{vision_feature_select_strategy}}`. Il est vivement recommandé d’ajouter ces attributs au processeur si vous êtes propriétaire du point de contrôle du modèle, ou d’ouvrir une demande de pull s’il ne vous appartient pas.
L’ajout de ces attributs permet à LLaVA de tenter de déduire le nombre de jetons d’image requis par image et d’étendre le texte avec autant de placeholders `` qu’il y aura de jetons. Il s’agit généralement d’environ 500 jetons par image, il est donc essentiel de s’assurer que le texte n’est pas tronqué, car sinon une erreur se produira lors de la fusion des embeddings. Les attributs peuvent être obtenus à partir de la configuration du modèle, par exemple `model.config.vision_config.patch_size` ou `model.config.vision_feature_select_strategy`. L’attribut `num_additional_image_tokens` doit être `1` si l’architecture visuelle ajoute un jeton CLS, ou `0` si rien d’autre n’est ajouté aux patches visuels.
### Mise en forme des prompts avec des modèles de chat
Chaque **checkpoint** est entraîné avec un format de prompt spécifique, en fonction du modèle de langage de grande taille sous-jacent. Pour garantir un formatage correct, utilisez la méthode `apply_chat_template` du processeur.
**Important :**
- Vous devez construire un historique de conversation — passer une simple chaîne de caractères ne fonctionnera pas.
- Chaque message doit être un dictionnaire avec les clés `"role"` et `"content"`.
- Le `"content"` doit être une liste de dictionnaires pour différentes modalités comme `"text"` et `"image"`.
Voici un exemple de la structure à donner à votre entrée. Nous utiliserons [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf) et un historique de conversation composé de texte et d’image. Chaque champ de contenu doit être une liste de dictionnaires, comme suit :
```python
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image"},
{"type": "text", "text": "What’s shown in this image?"},
],
},
{
"role": "assistant",
"content": [{"type": "text", "text": "This image shows a red stop sign."},]
},
{
"role": "user",
"content": [
{"type": "text", "text": "Describe the image in more details."},
],
},
]
text_prompt = processor.apply_chat_template(conversation, add_generation_prompt=True)
# Note that the template simply formats your prompt, you still have to tokenize it and obtain pixel values for your images
print(text_prompt)
"USER: \nUSER: Describe the image in more details. ASSISTANT:"
```
- Si vous souhaitez construire vous-même un prompt de chat, voici une liste des formats de prompt acceptés par chaque point de contrôle llava :
Les modèles [llava-interleave](https://huggingface.co/collections/llava-hf/llava-interleave-668e19a97da0036aad4a2f19) nécessitent le format suivant :
```bash
"<|im_start|>user \nWhat is shown in this image?<|im_end|><|im_start|>assistant"
```
Pour une conversation à plusieurs tours :
```bash
"<|im_start|>user \n<|im_end|><|im_start|>assistant <|im_end|><|im_start|>user \n<|im_end|><|im_start|>assistant "
```
Les modèles [llava-1.5](https://huggingface.co/collections/llava-hf/llava-15-65f762d5b6941db5c2ba07e0) nécessitent le format suivant :
```bash
"USER: \n ASSISTANT:"
```
Pour une conversation à plusieurs tours :
```bash
"USER: \n ASSISTANT: USER: ASSISTANT: USER: ASSISTANT:"
```
🚀 **Bonus :** si vous utilisez `transformers>=4.49.0`, vous pouvez également obtenir une sortie vectorisée à partir de `apply_chat_template`. Consultez les **Exemples d'utilisation** ci-dessous pour plus de détails sur son utilisation.
## Exemples d'utilisation
### Inférence avec une seule entrée
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
conversation,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
### Inférence par lots
LLaVa prend également en charge l'inférence par lots. Voici comment procéder :
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
# Prepare a batch of two prompts
conversation_1 = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
conversation_2 = [
{
"role": "user",
"content": [
{"type": "image", "url": "http://images.cocodataset.org/val2017/000000039769.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
[conversation_1, conversation_2],
add_generation_prompt=True,
tokenize=True,
return_dict=True,
padding=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
## Remarque concernant la reproduction de l'implémentation originale
Afin de faire correspondre les logits de l'[implémentation originale](https://github.com/haotian-liu/LLaVA/tree/main), il est nécessaire de spécifier en plus `do_pad=True` lors de l'instantiation de `LlavaImageProcessor` :
```python
from transformers import LlavaImageProcessor
image_processor = LlavaImageProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf", do_pad=True)
```
### Utilisation de Flash Attention 2
Flash Attention 2 est une version encore plus rapide et optimisée de l'optimisation précédente, veuillez consulter la [section Flash Attention 2 des documents de performance](https://huggingface.co/docs/transformers/perf_infer_gpu_one).
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec LLaVa.
- Une [démo Google Colab](https://colab.research.google.com/drive/1qsl6cd2c8gGtEW1xV5io7S8NHh-Cp1TV?usp=sharing) sur la façon d’exécuter Llava sur une instance Google Colab gratuite en exploitant l’inférence 4 bits.
- Un [notebook similaire](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/LLaVa/Inference_with_LLaVa_for_multimodal_generation.ipynb) illustrant l'inférence par lots. 🌎
## LlavaConfig[[transformers.LlavaConfig]]
#### transformers.LlavaConfig[[transformers.LlavaConfig]]
```python
transformers.LlavaConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, image_token_index: int = 32000, image_seq_length: int = 576, projector_hidden_act: str = 'gelu', vision_feature_select_strategy: typing.Literal['default', 'full'] = 'default', vision_feature_layer: int | list[int] = -2, multimodal_projector_bias: bool = True, tie_word_embeddings: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/configuration_llava.py#L26)
**Paramètres :**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone visuel.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone de texte.
image_token_index (`int`, *facultatif*, valeur par défaut `32000`) : L'index du jeton d'image utilisé comme espace réservé pour les images d'entrée.
image_seq_length (`int`, *facultatif*, valeur par défaut `576`) : Longueur de séquence d'un embedding d'image.
projector_hidden_act (`str`, *facultatif*, par défaut `gelu`) : Fonction d'activation utilisée par le projecteur multimodal.
vision_feature_select_strategy (`Literal[default, full]`, *facultatif*, valeur par défaut `default`) : Stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle issue du backbone visuel.
vision_feature_layer (`Union[int, list[int]]`, *facultatif*, valeur par défaut `-2`) : L'indice de la couche à partir de laquelle sélectionner la fonction visuelle. Si plusieurs indices sont fournis, les fonctions visuelles des indices correspondants seront concaténées pour former les fonctions visuelles.
multimodal_projector_bias (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut utiliser un biais dans le projecteur multimodal.
tie_word_embeddings (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut lier les embeddings de poids selon la correspondance `tied_weights_keys` du modèle.
Ceci est la classe de configuration destinée à stocker la configuration d'un LlavaModel. Elle est utilisée pour instancier un modèle Llava en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import LlavaForConditionalGeneration, LlavaConfig, CLIPVisionConfig, LlamaConfig
>>> # Initializing a CLIP-vision config
>>> vision_config = CLIPVisionConfig()
>>> # Initializing a Llama config
>>> text_config = LlamaConfig()
>>> # Initializing a Llava llava-1.5-7b style configuration
>>> configuration = LlavaConfig(vision_config, text_config)
>>> # Initializing a model from the llava-1.5-7b style configuration
>>> model = LlavaForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LlavaImageProcessor[[transformers.LlavaImageProcessor]]
#### transformers.LlavaImageProcessor[[transformers.LlavaImageProcessor]]
```python
transformers.LlavaImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/image_processing_llava.py#L38)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 224}`) : Décrim les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.48145466, 0.4578275, 0.40821073]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.26862954, 0.26130258, 0.27577711]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Construit un processeur d’images LlavaImageProcessor.
#### prétraiter[[transformers.LlavaImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
#### transformers.LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
```python
transformers.LlavaImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/image_processing_pil_llava.py#L31)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 224}`) : Décrim les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.48145466, 0.4578275, 0.40821073]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.26862954, 0.26130258, 0.27577711]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Construit un processeur d’images LlavaImageProcessor.
#### prétraiter[[transformers.LlavaImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## LlavaProcessor[[transformers.LlavaProcessor]]
#### transformers.LlavaProcessor[[transformers.LlavaProcessor]]
```python
transformers.LlavaProcessor(image_processor = None, tokenizer = None, patch_size = None, vision_feature_select_strategy = None, chat_template = None, image_token = '', num_additional_image_tokens = 0, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/processing_llava.py#L32)
**Paramètres :**
image_processor (`LlavaImageProcessor`) : le processeur d'images est une entrée obligatoire.
tokenizer (`TokenizersBackend`) : le tokenizer est une entrée obligatoire.
patch_size (`int`, *facultatif*) : Taille du patch issue de la tour visuelle.
vision_feature_select_strategy (`str`, *facultatif*) : La stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle à partir du backbone visuel. Doit être identique à celle de la configuration du modèle
chat_template (`str`) : Un modèle Jinja pour convertir des listes de messages d'une conversation en une chaîne tokenisable.
image_token (`str`, *facultatif*, valeur par défaut `""`) : Jeton spécial utilisé pour indiquer l'emplacement de l'image.
num_additional_image_tokens (`int`, *facultatif*, valeur par défaut 0) : Nombre de jetons supplémentaires ajoutés aux embeddings d'image, tels que CLS (+1). Si le backbone n'a pas de CLS ni d'autres jetons supplémentaires ajoutés, il n'est pas nécessaire de définir cet argument.
Construit un LlavaProcessor qui encapsule un processeur d’images et un tokenizer en un seul processeur.
[LlavaProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaProcessor) offre toutes les fonctionnalités de [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor) et de [TokenizersBackend](/docs/transformers/v5.23.0/fr/main_classes/tokenizer#transformers.TokenizersBackend). Consultez [~LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor) et [~TokenizersBackend](/docs/transformers/v5.23.0/fr/main_classes/tokenizer#transformers.TokenizersBackend) pour plus d’informations.
#### __appel__[[transformers.LlavaProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *facultatif*) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes (chaîne pré-tokenisée). Si vous transmettez une entrée pré-tokenisée, définissez `is_split_into_words=True` pour éviter toute ambiguïté avec les entrées en lot.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *facultatif*) : Vidéo à prétraiter. S'attend à une vidéo unique ou à un lot de vidéos dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des vidéos dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *facultatif*) : L'audio ou le lot d'audios à préparer. Chaque audio peut être un tableau NumPy ou un tenseur PyTorch. Dans le cas d'un tableau NumPy/d'un tenseur PyTorch, chaque audio doit avoir la forme (C, T), où C est le nombre de canaux et T est la longueur en échantillons de l'audio.
return_mm_token_type_ids (`bool`, *kwargs*) : Indique s'il faut retourner les identifiants de type de jeton multimodal indiquant les positions des jetons de substitution multimodaux.
return_text_replacement_offsets (`bool`, *kwargs*) : Indique s'il faut retourner les décalages de caractères pour chaque emplacement multimodal et son remplacement.
return_tensors (`str` ou [TensorType](/docs/transformers/v5.23.0/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/fr/main_classes/processors#transformers.ProcessingKwargs), *facultatif*) : Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
## LlavaModel[[transformers.LlavaModel]]
#### transformers.LlavaModel[[transformers.LlavaModel]]
```python
transformers.LlavaModel(config: LlavaConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L131)
**Paramètres :**
config ([LlavaConfig](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle Llava, qui se compose d'un backbone visuel et d'un modèle de langage, sans tête de modélisation du langage.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.LlavaModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L216)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/v5.23.0/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor). Voir [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([LlavaProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaProcessor) utilise [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor) pour le traitement des images).
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les identifiants de position ?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *facultatif*) : États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et dans les blocs d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Il s'agit généralement des `past_key_values` renvoyés par le modèle à une étape antérieure du décodage, lorsque `use_cache=True` ou `config.use_cache=True`. Seule une instance de [Cache](/docs/transformers/v5.23.0/fr/internal/generation_utils#transformers.Cache) est autorisée en entrée, voir notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache). Si aucun `past_key_values` n'est transmis, [DynamicCache](/docs/transformers/v5.23.0/fr/internal/generation_utils#transformers.DynamicCache) est initialisé par défaut. Le modèle renverra le même format de cache que celui fourni en entrée. Si `past_key_values` sont utilisés, l'utilisateur doit fournir uniquement les `input_ids` non traités (ceux pour lesquels les états de clés et de valeurs passées ne sont pas fournis à ce modèle) de forme `(batch_size, unprocessed_length)` au lieu de tous les `input_ids` de forme `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
vision_feature_layer (`Union[int, list[int]]`, *facultatif*) : L'indice de la couche à partir de laquelle sélectionner la fonction visuelle. Si plusieurs indices sont fournis, les fonctions visuelles des indices correspondants seront concaténées pour former les fonctions visuelles.
vision_feature_select_strategy (`str`, *facultatif*) : La stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle issue du backbone visuel. Peut être `"default"` ou `"full"`.
image_sizes (`torch.Tensor` de forme `(batch_size, 2)`, *facultatif*) : Les dimensions des images du lot, sous la forme (hauteur, largeur) pour chaque image.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *facultatif*) : Dictionnaire dont les clés sont les modalités prises en charge et les valeurs sont les sorties encodées pour cette modalité. Chaque sortie encodée est un tuple composé de (`pooler_output`, *facultatif* : `last_hidden_states`, *facultatif* : `hidden_states`, *facultatif* : `attentions`) `pooler_output` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) est une séquence de fonctionnalités multimodales de l'encodeur fusionnées dans les embeddings de texte.
**Retourne :** `LlavaModelOutputWithPast` ou `tuple(torch.Tensor)`
Un `LlavaModelOutputWithPast` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([LlavaConfig](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaConfig)) et les entrées.
La méthode forward de [LlavaModel](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
Si `past_key_values` est utilisé, seule la dernière hidden-state des séquences de forme `(batch_size, 1, hidden_size)` est renvoyée.
- **past_key_values** (`Cache`, *facultatif*, renvoyé lorsque `use_cache=True` est passé ou lorsque `config.use_cache=True`) -- Il s'agit d'une instance de [Cache](/docs/transformers/v5.23.0/fr/internal/generation_utils#transformers.Cache). Pour plus de détails, consultez notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention) qui peuvent être utilisés (voir l'entrée `past_key_values`) pour accélérer le décodage séquentiel.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **image_hidden_states** (`torch.Tensor`, *facultatif*) -- Un `torch.Tensor` de taille `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states du modèle produit par l'encodeur visuel et après projection de l'état caché final.
#### get_image_features[[transformers.LlavaModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L140)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d’entrée. Les valeurs des pixels peuvent être obtenues à l’aide de [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor). Voir [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([LlavaProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaProcessor) utilise [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor) pour le traitement des images).
vision_feature_layer (`Union[int, list[int]]`, *facultatif*) : L'indice de la couche à partir de laquelle sélectionner la fonction visuelle. Si plusieurs indices sont fournis, les fonctions visuelles des indices correspondants seront concaténées pour former les fonctions visuelles.
vision_feature_select_strategy (`str`, *facultatif*) : La stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle issue du backbone visuel. Peut être `"default"` ou `"full"`.
image_sizes (`torch.Tensor` de forme `(batch_size, 2)`, *facultatif*) : Les dimensions des images du lot, sous la forme (hauteur, largeur) pour chaque image.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([LlavaConfig](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaConfig)) et les entrées.
Obtient les derniers états cachés de l'image depuis la tour de vision et applique la projection multimodale.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
#### get_placeholder_mask[[transformers.LlavaModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor, image_features: Tensor)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L192)
Obtient le masque de jetons multimodaux à partir de `input_ids` ou de `inputs_embeds`, et vérifie que le nombre de jetons multimodaux est égal à la longueur des caractéristiques multimodales. Si les longueurs diffèrent, une erreur est levée.
## LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
#### transformers.LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
```python
transformers.LlavaForConditionalGeneration(config: LlavaConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L281)
**Paramètres :**
config ([LlavaConfig](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle LLAVA, qui se compose d'un backbone de vision et d'un modèle de langage.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.LlavaForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, labels: typing.Optional[torch.LongTensor] = None, logits_to_keep: typing.Union[int, torch.Tensor] = 0, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L309)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/v5.23.0/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor). Voir [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([LlavaProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaProcessor) utilise [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor) pour le traitement des images).
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les identifiants de position ?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *facultatif*) : États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et dans les blocs d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Il s'agit généralement des `past_key_values` renvoyés par le modèle à une étape antérieure du décodage, lorsque `use_cache=True` ou `config.use_cache=True`. Seule une instance de [Cache](/docs/transformers/v5.23.0/fr/internal/generation_utils#transformers.Cache) est autorisée en entrée, voir notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache). Si aucun `past_key_values` n'est transmis, [DynamicCache](/docs/transformers/v5.23.0/fr/internal/generation_utils#transformers.DynamicCache) est initialisé par défaut. Le modèle renverra le même format de cache que celui fourni en entrée. Si `past_key_values` sont utilisés, l'utilisateur doit fournir uniquement les `input_ids` non traités (ceux pour lesquels les états de clés et de valeurs passées ne sont pas fournis à ce modèle) de forme `(batch_size, unprocessed_length)` au lieu de tous les `input_ids` de forme `(batch_size, sequence_length)`.
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
vision_feature_layer (`Union[int, list[int]]`, *facultatif*) : L'indice de la couche à partir de laquelle sélectionner la fonction visuelle. Si plusieurs indices sont fournis, les fonctions visuelles des indices correspondants seront concaténées pour former les fonctions visuelles.
vision_feature_select_strategy (`str`, *facultatif*) : La stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle issue du backbone visuel. Peut être `"default"` ou `"full"`.
labels (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Étiquettes pour le calcul de la perte de modélisation de langage masquée. Les indices doivent être compris dans `[0, ..., config.vocab_size]` ou égaux à -100 (voir la docstring de `input_ids`). Les jetons dont l'indice est défini sur `-100` sont ignorés (masqués) ; la perte n'est calculée que pour les jetons dont l'étiquette est comprise dans `[0, ..., config.vocab_size]`.
logits_to_keep (`Union[int, torch.Tensor]`, *facultatif*, valeur par défaut `0`) : Si c'est un `int`, calcule les logits pour les `logits_to_keep` derniers jetons. Si c'est `0`, calcule les logits pour tous les `input_ids` (cas particulier). Seuls les logits du dernier jeton sont nécessaires pour la génération, et les calculer uniquement pour ce jeton peut faire économiser de la mémoire, ce qui devient assez significatif pour les séquences longues ou les tailles de vocabulaire importantes. Si c'est un `torch.Tensor`, il doit être 1D et correspondre aux indices à conserver dans la dimension de la longueur de la séquence. C'est utile lors de l'utilisation du format de tenseurs empilés (une seule dimension pour le lot et la longueur de la séquence).
image_sizes (`torch.Tensor` de forme `(batch_size, 2)`, *facultatif*) : Les dimensions des images du lot, sous la forme (hauteur, largeur) pour chaque image.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *facultatif*) : Dictionnaire dont les clés sont les modalités prises en charge et les valeurs sont les sorties encodées pour cette modalité. Chaque sortie encodée est un tuple composé de (`pooler_output`, *facultatif* : `last_hidden_states`, *facultatif* : `hidden_states`, *facultatif* : `attentions`) `pooler_output` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) est une séquence de fonctionnalités multimodales de l'encodeur fusionnées dans les embeddings de texte.
**Retourne :** `LlavaCausalLMOutputWithPast` ou `tuple(torch.Tensor)`
Un `LlavaCausalLMOutputWithPast` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([LlavaConfig](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaConfig)) et les entrées.
La méthode forward de [LlavaForConditionalGeneration](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaForConditionalGeneration) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de modélisation du langage (pour la prédiction du jeton suivant).
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).
- **past_key_values** (`Cache`, *facultatif*, renvoyé lorsque `use_cache=True` est passé ou lorsque `config.use_cache=True`) -- Il s'agit d'une instance de [Cache](/docs/transformers/v5.23.0/fr/internal/generation_utils#transformers.Cache). Pour plus de détails, consultez notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention) qui peuvent être utilisés (voir l'entrée `past_key_values`) pour accélérer le décodage séquentiel.
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **image_hidden_states** (`torch.Tensor`, *facultatif*) -- Un `torch.Tensor` de taille `(batch_size, num_images, sequence_length, hidden_size)`. image_hidden_states du modèle produit par l'encodeur visuel et après projection de l'état caché final.
Exemple :
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> prompt = "USER: \nWhat's the content of the image? ASSISTANT:"
>>> url = "https://www.ilankelman.org/stopsigns/australia.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, text=prompt, return_tensors="pt")
>>> # Generate
>>> generate_ids = model.generate(**inputs, max_new_tokens=15)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"USER: \nWhat's the content of the image? ASSISTANT: The image features a busy city street with a stop sign prominently displayed"
```
#### get_image_features[[transformers.LlavaForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L294)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d’entrée. Les valeurs des pixels peuvent être obtenues à l’aide de [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor). Voir [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([LlavaProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaProcessor) utilise [LlavaImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaImageProcessor) pour le traitement des images).
vision_feature_layer (`Union[int, list[int]]`, *facultatif*) : L'indice de la couche à partir de laquelle sélectionner la fonction visuelle. Si plusieurs indices sont fournis, les fonctions visuelles des indices correspondants seront concaténées pour former les fonctions visuelles.
vision_feature_select_strategy (`str`, *facultatif*) : La stratégie de sélection des caractéristiques utilisée pour sélectionner la caractéristique visuelle issue du backbone visuel. Peut être `"default"` ou `"full"`.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([LlavaConfig](/docs/transformers/v5.23.0/fr/model_doc/llava#transformers.LlavaConfig)) et les entrées.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```