# MarkupLM
## Обзор
Модель MarkupLM была предложена в статье [MarkupLM: Pre-training of Text and Markup Language for Visually-rich Document Understanding](https://huggingface.co/papers/2110.08518) авторами Junlong Li, Yiheng Xu, Lei Cui, Furu Wei. MarkupLM представляет собой BERT, но применяется к HTML-страницам вместо исходных текстовых документов. Модель включает дополнительные слои эмбеддингов для повышения производительности, аналогично [LayoutLM](layoutlm).
Модель может использоваться для таких задач, как ответы на вопросы по веб-страницам или извлечение информации из веб-страниц. Она показывает наилучшие результаты на 2 важных бенчмарках:
- [WebSRC](https://x-lance.github.io/WebSRC/) — набор данных для понимания структурного чтения веб-страниц (похож на SQuAD, но для веб-страниц)
- [SWDE](https://www.researchgate.net/publication/221299838_From_one_tree_to_a_forest_a_unified_solution_for_structured_web_data_extraction), набор данных
для извлечения информации из веб-страниц (по сути, распознавание именованных сущностей на веб-страницах)
Аннотация из статьи следующая:
*Мультимодальное предварительное обучение с использованием текста, макета и изображений принесло значительный прогресс в области понимания документов с богатым визуальным содержанием (VrDU), особенно для документов с фиксированным макетом, таких как сканированные изображения документов. Однако существует большое количество цифровых документов, в которых информация о макете не является фиксированной и требует интерактивного и динамического рендеринга для визуализации, что затрудняет применение существующих подходов к предварительному обучению на основе макета. В данной статье мы предлагаем MarkupLM для задач понимания документов с использованием языков разметки в качестве основы, таких как документы на базе HTML/XML, где информация о тексте и разметке совместно предварительно обучается. Результаты экспериментов показывают, что предварительно обученная модель MarkupLM значительно превосходит существующие сильные базовые модели на нескольких задачах понимания документов. Предварительно обученная модель и код будут общедоступны.*
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/microsoft/unilm/tree/master/markuplm).
## Советы по использованию
- Помимо `input_ids`, [forward()](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMModel.forward) ожидает два дополнительных входа, а именно `xpath_tags_seq` и `xpath_subs_seq`.
Это теги XPATH и индексы для каждого токена во входной последовательности соответственно.
- Для подготовки всех данных для модели можно использовать [MarkupLMProcessor](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMProcessor). Подробнее см. в [руководстве по использованию](#usage-markuplmprocessor).
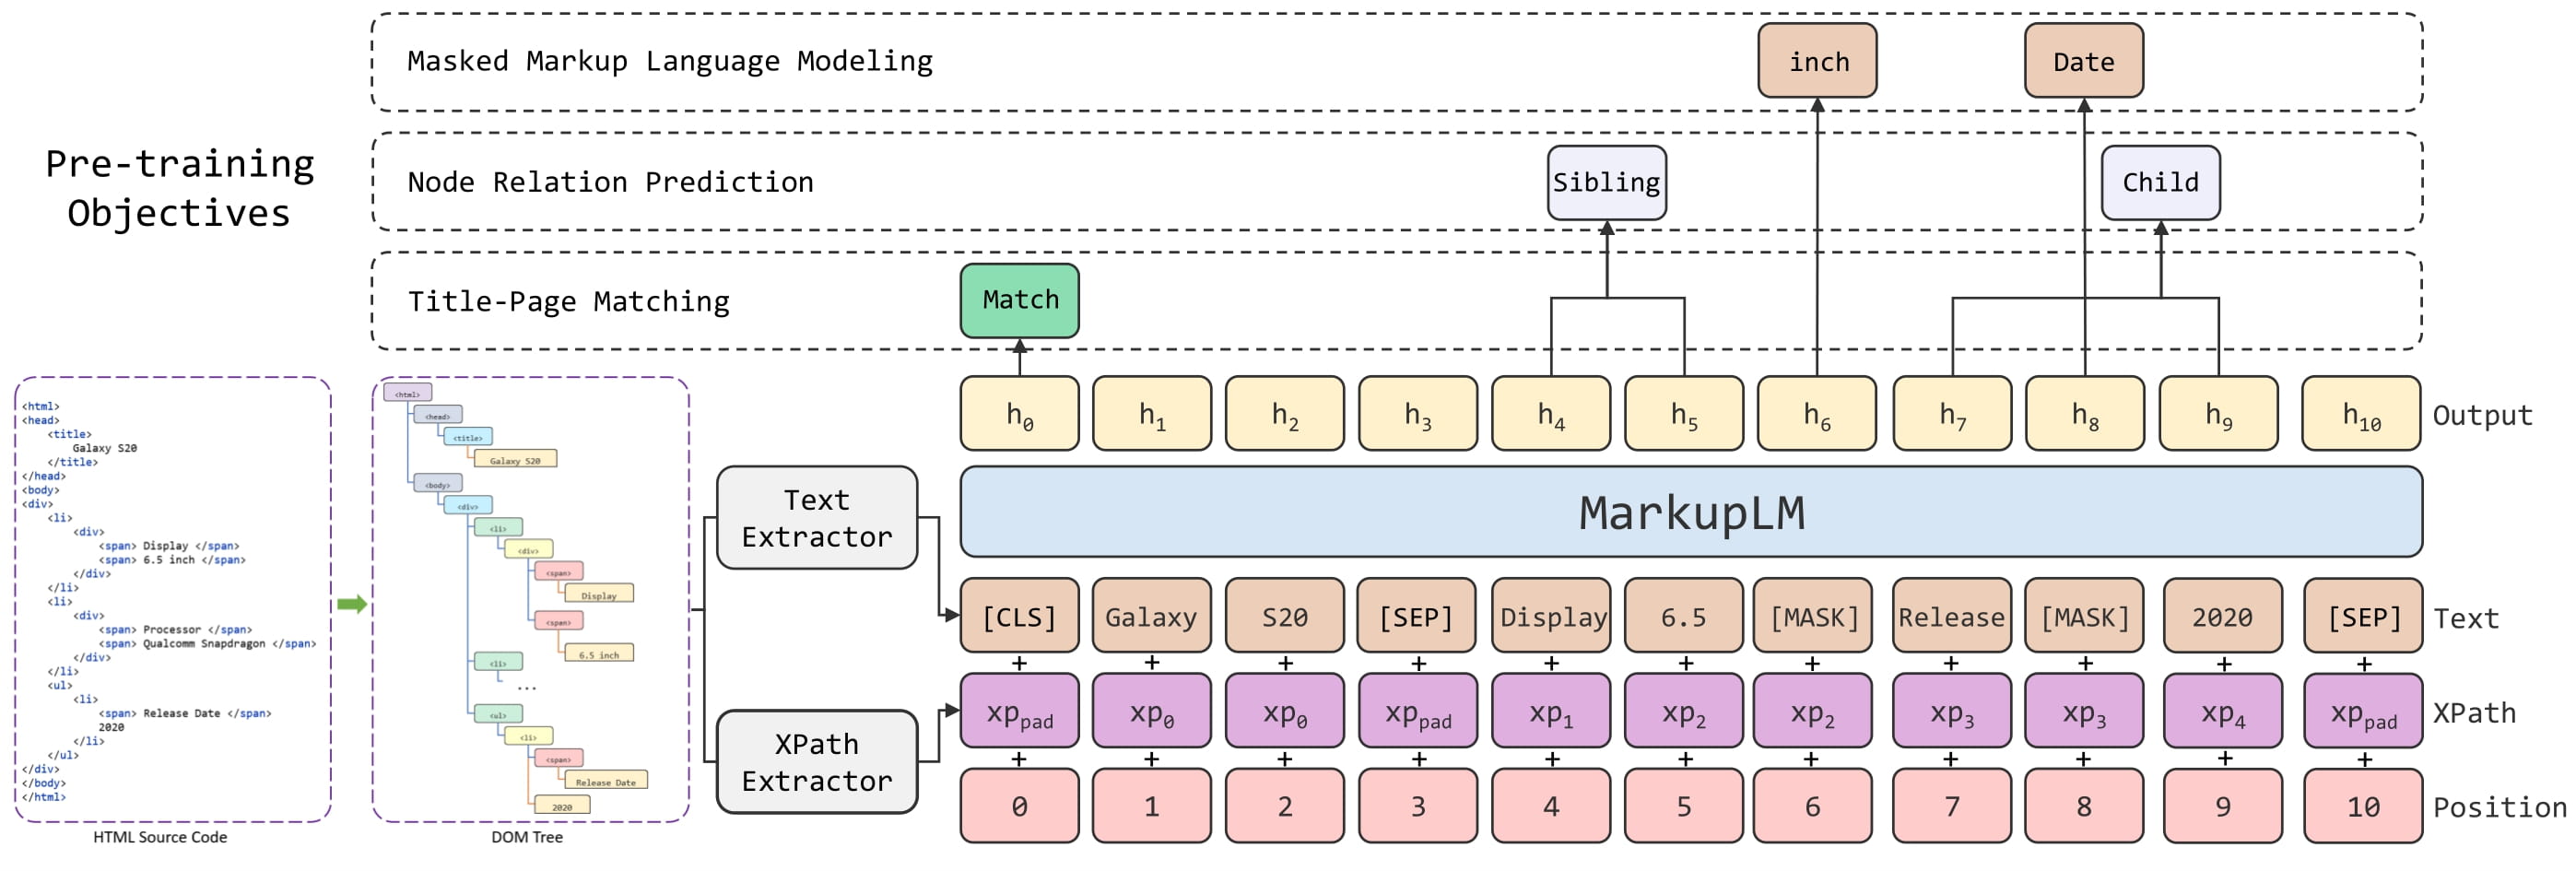 Архитектура MarkupLM. Взята из оригинальной статьи.
## Использование: MarkupLMProcessor
Самый простой способ подготовить данные для модели — использовать [MarkupLMProcessor](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMProcessor), который внутренне объединяет экстрактор признаков ([MarkupLMFeatureExtractor](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMFeatureExtractor)) и токенизатор ([MarkupLMTokenizer](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer) или [MarkupLMTokenizerFast](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer)). Экстрактор признаков используется для извлечения всех узлов и xpaths из HTML-строк, которые затем передаются токенизатору, преобразующему их во входные данные модели на уровне токенов (`input_ids` и т. д.). Обратите внимание, что вы по-прежнему можете использовать экстрактор признаков и токенизатор по отдельности, если вам нужно выполнять только одну из двух задач.
```python
from transformers import MarkupLMFeatureExtractor, MarkupLMProcessor, MarkupLMTokenizerFast
feature_extractor = MarkupLMFeatureExtractor()
tokenizer = MarkupLMTokenizerFast.from_pretrained("microsoft/markuplm-base")
processor = MarkupLMProcessor(feature_extractor, tokenizer)
```
Кратко: можно передать строки HTML (и, возможно, дополнительные данные) в [MarkupLMProcessor](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMProcessor), и он создаст входные данные, ожидаемые моделью. Внутри процессор сначала использует [MarkupLMFeatureExtractor](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMFeatureExtractor), чтобы получить список узлов и соответствующие xpath. Затем узлы и xpath передаются в [MarkupLMTokenizer](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer) или [MarkupLMTokenizerFast](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer), которые преобразуют их в токены `input_ids`, `attention_mask`, `token_type_ids`, `xpath_subs_seq`, `xpath_tags_seq`. По желанию можно передать в процессор метки узлов, которые преобразуются в токены `labels`.
[MarkupLMFeatureExtractor](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMFeatureExtractor) использует [Beautiful Soup](https://www.crummy.com/software/BeautifulSoup/bs4/doc/) — библиотеку Python для извлечения данных из файлов HTML и XML. Обратите внимание, что вы можете использовать собственное решение для разбора и самостоятельно передавать узлы и xpaths в [MarkupLMTokenizer](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer) или [MarkupLMTokenizerFast](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer).
Всего процессор поддерживает 5 сценариев использования. Ниже перечислены все они. Обратите внимание, что каждый из этих сценариев работает как с пакетными, так и с непакетными входными данными (для наглядности мы приводим примеры для непакетных входных данных).
**Сценарий 1: классификация веб-страниц (обучение, инференс) + классификация токенов (инференс), parse_html = True**
Это самый простой случай, в котором процессор использует feature extractor для получения всех узлов и xpaths из HTML.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
Here is my website.
"""
# note that you can also add provide all tokenizer parameters here such as padding, truncation
encoding = processor(html_string, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Сценарий 2: классификация веб-страниц (обучение, инференс) + классификация токенов (инференс), parse_html=False**
Если все узлы и xpaths уже получены, извлекатель признаков не нужен. В этом случае следует самостоятельно передать узлы и соответствующие xpaths в процессор и убедиться, что `parse_html` установлено в `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
encoding = processor(nodes=nodes, xpaths=xpaths, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Сценарий 3: классификация токенов (обучение), parse_html=False**
Для задач классификации токенов (например, [SWDE](https://paperswithcode.com/dataset/swde)) можно также предоставить соответствующие метки узлов для обучения модели. Процессор преобразует их в метки на уровне токенов `labels`. По умолчанию он присваивает метку только первому wordpiece слова, а остальные wordpiece помечает значением -100, что является `ignore_index` для CrossEntropyLoss в PyTorch. Если вы хотите, чтобы все wordpiece слова получали метки, инициализируйте токенизатор с параметром `only_label_first_subword`, установленным в `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
node_labels = [1, 2, 2, 1]
encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq', 'labels'])
```
**Сценарий 4: ответы на вопросы по веб-странице (инференс), parse_html=True**
Для задач по поиску ответов на веб-страницах вы можете передать вопрос в процессор. По умолчанию процессор использует извлекатель признаков для получения всех узлов и xpaths, а затем создаёт последовательность [CLS] вопрос [SEP] токены слов [SEP].
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
html_string = """
Hello world
Welcome
My name is Niels.
"""
question = "What's his name?"
encoding = processor(html_string, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
**Сценарий 5: ответы на вопросы по веб-странице (инференс), parse_html=False**
Для задач по ответам на вопросы (таких как WebSRC) вы можете передать вопрос в процессор. Если вы сами извлекли все узлы и xpaths, вы можете передать их непосредственно в процессор. Убедитесь, что параметр `parse_html` установлен в значение `False`.
```python
from transformers import MarkupLMProcessor
processor = MarkupLMProcessor.from_pretrained("microsoft/markuplm-base")
processor.parse_html = False
nodes = ["hello", "world", "how", "are"]
xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span", "html/body", "html/body/div"]
question = "What's his name?"
encoding = processor(nodes=nodes, xpaths=xpaths, questions=question, return_tensors="pt").to(model.device)
print(encoding.keys())
dict_keys(['input_ids', 'token_type_ids', 'attention_mask', 'xpath_tags_seq', 'xpath_subs_seq'])
```
## Ресурсы
- [Демо-ноутбуки](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/MarkupLM)
- [Руководство по задаче классификации текста](../tasks/sequence_classification)
- [Руководство по задаче классификации токенов](../tasks/token_classification)
- [Руководство по задаче вопрос-ответ](../tasks/question_answering)
## MarkupLMConfig[[transformers.MarkupLMConfig]]
#### transformers.MarkupLMConfig[[transformers.MarkupLMConfig]]
```python
transformers.MarkupLMConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, type_vocab_size: int = 2, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, max_xpath_tag_unit_embeddings: int = 256, max_xpath_subs_unit_embeddings: int = 1024, tag_pad_id: int = 216, subs_pad_id: int = 1001, xpath_unit_hidden_size: int = 32, max_depth: int = 50, use_cache: bool = True, classifier_dropout: float | int | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/configuration_markuplm.py#L24)
**Параметры:**
vocab_size (`int`, *необязательный*, по умолчанию `30522`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Вероятность dropout для всех полносвязных слоев в эмбеддингах, энкодере и пулере.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Доля dropout для вероятностей внимания.
max_position_embeddings (`int`, *необязательный*, по умолчанию `512`) : Максимальная длина последовательности, с которой может использоваться данная модель.
type_vocab_size (`int`, *необязательный*, по умолчанию `2`) : Размер словаря для `token_type_ids`.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
pad_token_id (`int`, *необязательный*, по умолчанию `0`) : Идентификатор токена, используемый для выравнивания в словаре.
bos_token_id (`int`, *необязательный*, по умолчанию `0`) : Идентификатор токена, используемый для обозначения начала потока в словаре.
eos_token_id (`Union[int, list[int]]`, *необязательный*, по умолчанию `2`) : Идентификатор токена, используемого для обозначения конца потока в словаре.
max_xpath_tag_unit_embeddings (`int`, *optional*, по умолчанию 256) : Максимальное значение, которое может использовать встраивание единиц xpath-тегов. Как правило, устанавливайте это значение достаточно большим на всякий случай (например, 256).
max_xpath_subs_unit_embeddings (`int`, *optional*, по умолчанию 1024) : Максимальное значение, которое может использовать встраивание единицы подстановки xpath. Как правило, устанавливайте это значение достаточно большим на всякий случай (например, 1024).
tag_pad_id (`int`, *optional*, по умолчанию 216) : Идентификатор токена отступов в xpath-тегах.
subs_pad_id (`int`, *необязательный*, по умолчанию 1001) : Идентификатор токена отступов в подстрочных индексах xpath.
xpath_unit_hidden_size (`int`, *optional*, по умолчанию 32) : Размер скрытого слоя каждой единицы в xpath.
max_depth (`int`, *optional*, по умолчанию 50) : Максимальная глубина в xpath.
use_cache (`bool`, *необязательный*, по умолчанию `True`) : Следует ли модели возвращать последние значения внимания key/values (не используется во всех моделях). Актуально только при `config.is_decoder=True` или если модель является генеративной моделью только с декодером.
classifier_dropout (`Union[float, int]`, *необязательный*) : Коэффициент dropout для классификатора.
Это класс конфигурации для хранения настроек модели MarkupLMModel. Он используется для создания модели Markuplm в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [microsoft/markuplm-base](https://huggingface.co/microsoft/markuplm-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Примеры:
```python
>>> from transformers import MarkupLMModel, MarkupLMConfig
>>> # Initializing a MarkupLM microsoft/markuplm-base style configuration
>>> configuration = MarkupLMConfig()
>>> # Initializing a model from the microsoft/markuplm-base style configuration
>>> model = MarkupLMModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
#### transformers.MarkupLMFeatureExtractor[[transformers.MarkupLMFeatureExtractor]]
```python
transformers.MarkupLMFeatureExtractor(**kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/feature_extraction_markuplm.py#L32)
Создаёт экстрактор признаков MarkupLM. Его можно использовать для получения списка узлов и соответствующих xpath-выражений из HTML-строк.
Этот экстрактор признаков наследуется от `PreTrainedFeatureExtractor()`, который содержит большинство основных методов. За дополнительной информацией о них следует обращаться к этому суперклассу.
#### __call__[[transformers.MarkupLMFeatureExtractor.__call__]]
```python
__call__(html_strings)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/feature_extraction_markuplm.py#L98)
**Параметры:**
html_strings (`str`, `list[str]`) : HTML-строка или батч HTML-строк, из которых необходимо извлечь узлы и соответствующие им xpath-выражения.
**Возвращает:** [BatchFeature](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.BatchFeature)
Объект [BatchFeature](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.BatchFeature) со следующими полями:
- **nodes** -- Узлы.
- **xpaths** -- Соответствующие xpaths.
Основной метод для подготовки одной или нескольких HTML-строк для модели.
Примеры:
```python
>>> from transformers import MarkupLMFeatureExtractor
>>> page_name_1 = "page1.html"
>>> page_name_2 = "page2.html"
>>> page_name_3 = "page3.html"
>>> with open(page_name_1) as f:
... single_html_string = f.read()
>>> feature_extractor = MarkupLMFeatureExtractor()
>>> # single example
>>> encoding = feature_extractor(single_html_string)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
>>> # batched example
>>> multi_html_strings = []
>>> with open(page_name_2) as f:
... multi_html_strings.append(f.read())
>>> with open(page_name_3) as f:
... multi_html_strings.append(f.read())
>>> encoding = feature_extractor(multi_html_strings)
>>> print(encoding.keys())
>>> # dict_keys(['nodes', 'xpaths'])
```
## MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Параметры:**
vocab (`str` или `dict[str, int]`, *необязательный*) : Пользовательский словарь. Если не указан, словарь загружается из `vocab_file`.
merges (`str` или `list[str]`, *необязательный*) : Пользовательский список слияний. Если не указан, слияния загружаются из `merges_file`.
errors (`str`, *необязательный*, по умолчанию `"replace"`) : Парадигма, которой следует при декодировании байтов в UTF-8. Подробнее см. [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode).
bos_token (`str`, *optional*, по умолчанию `""`) : Токен начала последовательности, использовавшийся во время предварительного обучения. Может использоваться в качестве токена классификатора последовательности. При построении последовательности с использованием специальных токенов этот токен не используется для обозначения начала последовательности. Для этой цели применяется токен `cls_token`.
eos_token (`str`, *необязательный*, по умолчанию `""`) : Токен конца последовательности. При построении последовательности с использованием специальных токенов этот токен не используется для обозначения конца последовательности. Вместо него применяется токен `sep_token`.
sep_token (`str`, *необязательный*, по умолчанию `""`) : Токен-разделитель, который используется при построении последовательности из нескольких последовательностей, например, двух последовательностей для классификации последовательностей или текста и вопроса для ответа на вопросы. Он также используется в качестве последнего токена последовательности, построенной с помощью специальных токенов.
cls_token (`str`, *необязательный*, по умолчанию `""`) : Токен классификатора, используемый при классификации последовательности (классификация всей последовательности, а не посимвольная классификация). Это первый токен последовательности, если она построена с использованием специальных токенов.
unk_token (`str`, *необязательный*, по умолчанию `""`) : Неизвестный токен. Токен, отсутствующий в словаре, не может быть преобразован в ID, вместо этого ему присваивается данный токен.
pad_token (`str`, *необязательный*, по умолчанию `""`) : токен, используемый для выравнивания, например, при пакетной обработке последовательностей разной длины.
mask_token (`str`, *необязательный*, по умолчанию `""`) : Токен, используемый для маскирования значений. Это тот токен, который применяется при обучении модели с использованием маскированного языкового моделирования. Именно этот токен модель будет пытаться предсказать.
add_prefix_space (`bool`, *необязательный*, по умолчанию `False`) : Добавлять ли начальный пробел к входным данным. Это позволяет обрабатывать первое слово так же, как и любое другое. (Токенизатор RoBERTa определяет начало слов по предшествующему пробелу).
Создайте токенизатор MarkupLM. Основан на байтовом уровне Byte-Pair-Encoding (BPE).
[MarkupLMTokenizer](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer) можно использовать для преобразования HTML-строк в токены уровня `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` и `xpath_tags_seq`. Этот токенизатор наследуется от [TokenizersBackend](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.TokenizersBackend), который содержит большинство основных методов и гарантирует, что бэкенд `tokenizers` всегда инициализируется.
Для получения дополнительной информации об этих методах пользователям следует обратиться к этому суперклассу.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Параметры:**
token_ids_0 (`list[int]`) : Список идентификаторов, к которым будут добавлены специальные токены.
token_ids_1 (`list[int]`, *необязательный*) : Необязательный второй список идентификаторов для пар последовательностей.
**Возвращает:** `list[int]`
Список [идентификаторов входных токенов](../glossary#input-ids) с соответствующими специальными токенами.
Создайте входные данные модели из последовательности или пары последовательностей для задач классификации последовательностей, объединяя их и добавляя специальные токены. Последовательность RoBERTa имеет следующий формат:
- одна последовательность: ` X `
- пара последовательностей: ` A B `
#### get_special_tokens_mask[[transformers.MarkupLMTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/tokenization_utils_base.py#L1337)
**Параметры:**
token_ids_0 : список идентификаторов для (возможно, уже отформатированной) последовательности.
token_ids_1 : Не используется, если `already_has_special_tokens=True`. В этом случае должно быть None.
already_has_special_tokens : Указывает, уже ли последовательность отформатирована со специальными токенами.
**Возвращаемое значение:** список целых чисел в диапазоне [0, 1]
1 для специального токена, 0 для токена последовательности.
Получить идентификаторы последовательностей из списка токенов, в который не добавлены специальные токены.
Для быстрых токенизаторов коллабораторы данных вызывают этот метод с `already_has_special_tokens=True`, чтобы построить маску для уже отформатированной последовательности. В этом случае маска вычисляется путём проверки принадлежности элементов `all_special_ids`.
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Параметры:**
token_ids_0 (`list[int]`) : Список идентификаторов.
token_ids_1 (`list[int]`, *необязательный*) : Необязательный второй список идентификаторов для пар последовательностей.
**Возвращает:** `list[int]`
Список нулей.
Создаёт маску на основе двух переданных последовательностей для использования в задаче классификации пар последовательностей. RoBERTa не использует идентификаторы типов токенов, поэтому возвращается список нулей.
#### save_vocabulary[[transformers.MarkupLMTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L997)
## MarkupLMTokenizerFast[[transformers.MarkupLMTokenizer]]
#### transformers.MarkupLMTokenizer[[transformers.MarkupLMTokenizer]]
```python
transformers.MarkupLMTokenizer(tags_dict, vocab: str | dict[str, int] | list[tuple[str, float]] | None = None, merges: str | list[str] | None = None, errors = 'replace', bos_token = '', eos_token = '', sep_token = '', cls_token = '', unk_token = '', pad_token = '', mask_token = '', add_prefix_space = False, max_depth = 50, max_width = 1000, pad_width = 1001, pad_token_label = -100, only_label_first_subword = True, trim_offsets = False, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L91)
**Параметры:**
vocab (`str` или `dict[str, int]`, *необязательный*) : Пользовательский словарь. Если не указан, словарь загружается из `vocab_file`.
merges (`str` или `list[str]`, *необязательный*) : Пользовательский список слияний. Если не указан, слияния загружаются из `merges_file`.
errors (`str`, *необязательный*, по умолчанию `"replace"`) : Парадигма, которой следует при декодировании байтов в UTF-8. Подробнее см. [bytes.decode](https://docs.python.org/3/library/stdtypes.html#bytes.decode).
bos_token (`str`, *optional*, по умолчанию `""`) : Токен начала последовательности, использовавшийся во время предварительного обучения. Может использоваться в качестве токена классификатора последовательности. При построении последовательности с использованием специальных токенов этот токен не используется для обозначения начала последовательности. Для этой цели применяется токен `cls_token`.
eos_token (`str`, *необязательный*, по умолчанию `""`) : Токен конца последовательности. При построении последовательности с использованием специальных токенов этот токен не используется для обозначения конца последовательности. Вместо него применяется токен `sep_token`.
sep_token (`str`, *необязательный*, по умолчанию `""`) : Токен-разделитель, который используется при построении последовательности из нескольких последовательностей, например, двух последовательностей для классификации последовательностей или текста и вопроса для ответа на вопросы. Он также используется в качестве последнего токена последовательности, построенной с помощью специальных токенов.
cls_token (`str`, *необязательный*, по умолчанию `""`) : Токен классификатора, используемый при классификации последовательности (классификация всей последовательности, а не посимвольная классификация). Это первый токен последовательности, если она построена с использованием специальных токенов.
unk_token (`str`, *необязательный*, по умолчанию `""`) : Неизвестный токен. Токен, отсутствующий в словаре, не может быть преобразован в ID, вместо этого ему присваивается данный токен.
pad_token (`str`, *необязательный*, по умолчанию `""`) : токен, используемый для выравнивания, например, при пакетной обработке последовательностей разной длины.
mask_token (`str`, *необязательный*, по умолчанию `""`) : Токен, используемый для маскирования значений. Это тот токен, который применяется при обучении модели с использованием маскированного языкового моделирования. Именно этот токен модель будет пытаться предсказать.
add_prefix_space (`bool`, *необязательный*, по умолчанию `False`) : Добавлять ли начальный пробел к входным данным. Это позволяет обрабатывать первое слово так же, как и любое другое. (Токенизатор RoBERTa определяет начало слов по предшествующему пробелу).
Создайте токенизатор MarkupLM. Основан на байтовом уровне Byte-Pair-Encoding (BPE).
[MarkupLMTokenizer](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer) можно использовать для преобразования HTML-строк в токены уровня `input_ids`, `attention_mask`, `token_type_ids`, `xpath_tags_seq` и `xpath_tags_seq`. Этот токенизатор наследуется от [TokenizersBackend](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.TokenizersBackend), который содержит большинство основных методов и гарантирует, что бэкенд `tokenizers` всегда инициализируется.
Для получения дополнительной информации об этих методах пользователям следует обратиться к этому суперклассу.
#### batch_encode_plus[[transformers.MarkupLMTokenizer.batch_encode_plus]]
```python
batch_encode_plus(batch_text_or_text_pairs: list[str] | list[tuple[str, str]] | list[list[str]], is_pair: bool | None = None, xpaths: list[list[list[int]]] | None = None, node_labels: list[int] | list[list[int]] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L453)
add_special_tokens (`bool`, *необязательный*, по умолчанию `True`): добавлять ли специальные токены при кодировании последовательностей. Для этого используется базовая функция `PretrainedTokenizerBase.build_inputs_with_special_tokens`, которая определяет, какие токены автоматически добавляются к входным идентификаторам. Это полезно, если вы хотите автоматически добавлять токены `bos` или `eos`. padding (`bool`, `str` или [PaddingStrategy](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.utils.PaddingStrategy), *необязательный*, по умолчанию `False`): активирует и управляет выравниванием. Принимает следующие значения:
- `True` или `'longest'`: дополнить до самой длинной последовательности в батче (или не дополнять, если предоставлена только одна последовательность).
- `'max_length'`: Дополнить до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой длины входных данных для модели, если этот аргумент не указан.
- `False` или `'do_not_pad'` (по умолчанию): без дополнения нулями (т.е. может выводить батч с последовательностями разной длины).
truncation (`bool`, `str` или [TruncationStrategy](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *необязательный*, по умолчанию `False`): Включает и управляет усечением. Принимает следующие значения:
- `True` или `'longest_first'`: обрезка до максимальной длины, заданной аргументом `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Обрезка выполняется посимвольно: если предоставлена пара последовательностей (или батч пар), то токен удаляется из самой длинной последовательности в паре.
- `'only_first'`: Обрезка до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой длины входных данных для модели, если этот аргумент не задан. Если предоставлена пара последовательностей (или батч пар), будет обрезана только первая последовательность в паре.
- `'only_second'`: Обрезка до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой длины входа для модели, если этот аргумент не задан. Это приводит к обрезке только второй последовательности в паре, если предоставлена пара последовательностей (или батч пар).
- `False` или `'do_not_truncate'` (по умолчанию): без усечения (то есть может выдать батч с длиной последовательности, превышающей максимальный допустимый размер входа модели).
max_length (`int`, *optional*): Управляет максимальной длиной, используемой одним из параметров усечения/дополнения.
If left unset or set to `None`, this will use the predefined model maximum length if a maximum length is required by one of the truncation/padding parameters. If the model has no specific maximum input length (like XLNet) truncation/padding to a maximum length will be deactivated. stride (`int`, *optional*, defaults to 0): If set to a number along with `max_length`, the overflowing tokens returned when `return_overflowing_tokens=True` will contain some tokens from the end of the truncated sequence returned to provide some overlap between truncated and overflowing sequences. The value of this argument defines the number of overlapping tokens. is_split_into_words (`bool`, *optional*, defaults to `False`): Whether or not the input is already pre-tokenized (e.g., split into words). If set to `True`, the tokenizer assumes the input is already split into words (for instance, by splitting it on whitespace) which it will tokenize. This is useful for NER or token classification. pad_to_multiple_of (`int`, *optional*): If set will pad the sequence to a multiple of the provided value. Requires `padding` to be activated. This is especially useful to enable the use of Tensor Cores on NVIDIA hardware with compute capability `>= 7.5` (Volta). padding_side (`str`, *optional*): The side on which the model should have padding applied. Should be selected between ['right', 'left']. Default value is picked from the class attribute of the same name. return_tensors (`str` or [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*): If set, will return tensors instead of list of python integers. Acceptable values are:
- `'pt'`: возвращает объекты `torch.Tensor` PyTorch.
- `'np'`: возвращает объекты Numpy `np.ndarray`.
add_special_tokens (`bool`, *необязательный*, по умолчанию `True`): кодируются ли последовательности со специальными токенами относительно их модели. padding (`bool`, `str` или [PaddingStrategy](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.utils.PaddingStrategy), *необязательный*, по умолчанию `False`): активирует и управляет выравниванием. Принимает следующие значения:
- `True` или `'longest'`: дополнить до самой длинной последовательности в батче (или не дополнять, если предоставлена только одна последовательность).
- `'max_length'`: Дополнить до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой длины входных данных для модели, если этот аргумент не указан.
- `False` или `'do_not_pad'` (по умолчанию): без дополнения нулями (т.е. может выводить батч с последовательностями разной длины).
truncation (`bool`, `str` или [TruncationStrategy](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *необязательный*, по умолчанию `False`): Включает и управляет усечением. Принимает следующие значения:
- `True` или `'longest_first'`: обрезка до максимальной длины, заданной аргументом `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Обрезка выполняется посимвольно: если предоставлена пара последовательностей (или батч пар), то токен удаляется из самой длинной последовательности в паре.
- `'only_first'`: Обрезка до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой длины входных данных для модели, если этот аргумент не задан. Если предоставлена пара последовательностей (или батч пар), будет обрезана только первая последовательность в паре.
- `'only_second'`: Обрезка до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой длины входа для модели, если этот аргумент не задан. Это приводит к обрезке только второй последовательности в паре, если предоставлена пара последовательностей (или батч пар).
- `False` или `'do_not_truncate'` (по умолчанию): без усечения (то есть может выдать батч с длиной последовательности, превышающей максимальный допустимый размер входа модели).
max_length (`int`, *optional*): Controls the maximum length to use by one of the truncation/padding parameters. If left unset or set to `None`, this will use the predefined model maximum length if a maximum length is required by one of the truncation/padding parameters. If the model has no specific maximum input length (like XLNet) truncation/padding to a maximum length will be deactivated. stride (`int`, *optional*, defaults to 0): If set to a number along with `max_length`, the overflowing tokens returned when `return_overflowing_tokens=True` will contain some tokens from the end of the truncated sequence returned to provide some overlap between truncated and overflowing sequences. The value of this argument defines the number of overlapping tokens. is_split_into_words (`bool`, *optional*, defaults to `False`): Whether or not the input is already pretokenized (e.g. split into words). Set this to `True` if you are passing pretokenized inputs to avoid additional tokenization. pad_to_multiple_of (`int`, *optional*): If set will pad the sequence to a multiple of the provided value. This is especially useful to enable the use of Tensor Cores on NVIDIA hardware with compute capability `>= 7.5` (Volta). return_tensors (`str` or [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*): If set, will return tensors instead of list of python integers. Acceptable values are:
- `'pt'`: возвращает объекты `torch.Tensor` PyTorch.
- `'np'`: возвращает объекты Numpy `np.ndarray`.
#### build_inputs_with_special_tokens[[transformers.MarkupLMTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L952)
**Параметры:**
token_ids_0 (`list[int]`) : Список идентификаторов, к которым будут добавлены специальные токены.
token_ids_1 (`list[int]`, *необязательный*) : Необязательный второй список идентификаторов для пар последовательностей.
**Возвращает:** `list[int]`
Список [идентификаторов входных токенов](../glossary#input-ids) с соответствующими специальными токенами.
Создайте входные данные модели из последовательности или пары последовательностей для задач классификации последовательностей, объединяя их и добавляя специальные токены. Последовательность RoBERTa имеет следующий формат:
- одна последовательность: ` X `
- пара последовательностей: ` A B `
#### create_token_type_ids_from_sequences[[transformers.MarkupLMTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list[int], token_ids_1: list[int] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L975)
**Параметры:**
token_ids_0 (`list[int]`) : Список идентификаторов.
token_ids_1 (`list[int]`, *необязательный*) : Необязательный второй список идентификаторов для пар последовательностей.
**Возвращает:** `list[int]`
Список нулей.
Создаёт маску на основе двух переданных последовательностей для использования в задаче классификации пар последовательностей. RoBERTa не использует идентификаторы типов токенов, поэтому возвращается список нулей.
#### encode_plus[[transformers.MarkupLMTokenizer.encode_plus]]
```python
encode_plus(text: str | list[str], text_pair: list[str] | None = None, xpaths: list[list[int]] | None = None, node_labels: list[int] | None = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L518)
**Параметры:**
text (`str`, `list[str]`, `list[list[str]]`) : Первая последовательность для кодирования. Может быть строкой, списком строк или списком списков строк.
text_pair (`list[str]` или `list[int]`, *необязательный*) : Необязательная вторая последовательность для кодирования. Это может быть список строк (слова одного примера) или список списков строк (слова батча примеров).
add_special_tokens (`bool`, *необязательный*, по умолчанию `True`) : Указывает, следует ли добавлять специальные токены при кодировании последовательностей. Для этого используется базовая функция `PretrainedTokenizerBase.build_inputs_with_special_tokens`, которая определяет, какие токены автоматически добавляются к входным идентификаторам. Это полезно, если вы хотите автоматически добавлять токены `bos` или `eos`.
padding (`bool`, `str` или [PaddingStrategy](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.utils.PaddingStrategy), *необязательный*, по умолчанию `False`) : Включает и управляет выравниванием. Принимает следующие значения: - `True` или `'longest'`: Выравнивание до самой длинной последовательности в батче (или без выравнивания, если предоставлена только одна последовательность). - `'max_length'`: Выравнивание до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. - `False` или `'do_not_pad'` (по умолчанию): Без выравнивания (т. е. на выходе может быть батч с последовательностями разной длины).
truncation (`bool`, `str` или [TruncationStrategy](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *необязательный*, по умолчанию `False`) : Включает и управляет усечением. Принимает следующие значения: - `True` или `'longest_first'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Усечение выполняется посимвольно: если предоставлена пара последовательностей (или пакет пар), то символ удаляется из самой длинной последовательности в паре. - `'only_first'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или пакет пар), усечение выполняется только для первой последовательности в паре. - `'only_second'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или пакет пар), усечение выполняется только для второй последовательности в паре. - `False` или `'do_not_truncate'` (по умолчанию): Усечение не выполняется (т. е. на выходе может быть пакет с длинами последовательностей, превышающими максимально допустимый размер входных данных модели).
max_length (`int`, *optional*) : Управляет максимальной длиной, используемой одним из параметров усечения/дополнения. Если значение не задано или равно `None`, будет использована предопределённая максимальная длина модели, если один из параметров усечения/дополнения требует указания максимальной длины. Если у модели нет конкретной максимальной длины входных данных (как у XLNet), усечение/дополнение до максимальной длины будет отключено.
stride (`int`, *optional*, по умолчанию 0) : Если задано число вместе с `max_length`, то переполненные токены, возвращаемые при `return_overflowing_tokens=True`, будут содержать некоторые токены из конца усечённой последовательности, чтобы обеспечить перекрытие между усечённой и переполненной последовательностями. Значение этого аргумента определяет количество перекрывающихся токенов.
is_split_into_words (`bool`, *необязательный*, по умолчанию `False`) : Указывает, является ли вход уже предтокенизированным (например, разбитым на слова). Если установлено в `True`, токенизатор предполагает, что вход уже разбит на слова (например, по пробелам), и токенизирует их. Это полезно для NER или классификации токенов.
pad_to_multiple_of (`int`, *optional*) : Если задано, последовательность будет дополнена до кратного указанного значения. Требуется, чтобы `padding` был активирован. Это особенно полезно для использования Tensor Cores на аппаратных средствах NVIDIA с вычислительной способностью `>= 7.5` (Volta).
padding_side (`str`, *необязательный*) : Сторона, на которой модель должна применять выравнивание. Значение выбирается из ['right', 'left']. Значение по умолчанию берётся из атрибута класса с тем же именем.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры вместо списка целых чисел Python. Допустимые значения: - `'pt'`: Возвращает объекты `torch.Tensor` PyTorch. - `'np'`: Возвращает объекты `np.ndarray` Numpy.
add_special_tokens (`bool`, *необязательный*, по умолчанию `True`) : Нужно ли кодировать последовательности со специальными токенами в соответствии с их моделью.
padding (`bool`, `str` или [PaddingStrategy](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.utils.PaddingStrategy), *необязательный*, по умолчанию `False`) : Включает и управляет выравниванием. Принимает следующие значения: - `True` или `'longest'`: Выравнивание до самой длинной последовательности в батче (или без выравнивания, если предоставлена только одна последовательность). - `'max_length'`: Выравнивание до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. - `False` или `'do_not_pad'` (по умолчанию): Без выравнивания (т. е. может выдать батч с последовательностями разной длины).
truncation (`bool`, `str` или [TruncationStrategy](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *необязательный*, по умолчанию `False`) : Включает и управляет усечением. Принимает следующие значения: - `True` или `'longest_first'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Усечение выполняется посимвольно: если предоставлена пара последовательностей (или пакет пар), то символ удаляется из самой длинной последовательности в паре. - `'only_first'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или пакет пар), усечение выполняется только для первой последовательности в паре. - `'only_second'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или пакет пар), усечение выполняется только для второй последовательности в паре. - `False` или `'do_not_truncate'` (по умолчанию): Усечение не выполняется (т. е. на выходе может быть пакет с длинами последовательностей, превышающими максимально допустимый размер входных данных модели).
max_length (`int`, *optional*) : Управляет максимальной длиной, используемой одним из параметров усечения/дополнения. Если значение не задано или равно `None`, будет использована предопределённая максимальная длина модели, если один из параметров усечения/дополнения требует указания максимальной длины. Если у модели нет конкретной максимальной длины входных данных (как у XLNet), усечение/дополнение до максимальной длины будет отключено.
stride (`int`, *optional*, по умолчанию 0) : Если задано число вместе с `max_length`, то переполненные токены, возвращаемые при `return_overflowing_tokens=True`, будут содержать некоторые токены из конца усечённой последовательности, чтобы обеспечить перекрытие между усечённой и переполненной последовательностями. Значение этого аргумента определяет количество перекрывающихся токенов.
is_split_into_words (`bool`, *необязательный*, по умолчанию `False`) : Указывает, является ли вход уже предрасщеплённым (например, разбитым на слова). Установите это значение в `True`, если вы передаёте предрасщеплённые входные данные, чтобы избежать дополнительного токенизации.
pad_to_multiple_of (`int`, *optional*) : Если задано, последовательность будет дополнена нулями до кратного указанного значения. Это особенно полезно для использования Tensor Cores на аппаратных платформах NVIDIA с вычислительной способностью `>= 7.5` (Volta).
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры вместо списка целых чисел Python. Допустимые значения: - `'pt'`: Возвращает объекты `torch.Tensor` PyTorch. - `'np'`: Возвращает объекты `np.ndarray` Numpy.
Токенизация и подготовка последовательности или пары последовательностей для модели. .. warning:: Этот метод устарел, вместо него следует использовать `__call__`.
#### get_xpath_seq[[transformers.MarkupLMTokenizer.get_xpath_seq]]
```python
get_xpath_seq(xpath)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/tokenization_markuplm.py#L253)
По заданному xpath-выражению конкретного узла (например, /html/body/div/li[1]/div/span[2]) верните список идентификаторов тегов и соответствующих им индексов, учитывая максимальную глубину.
## MarkupLMProcessor[[transformers.MarkupLMProcessor]]
#### transformers.MarkupLMProcessor[[transformers.MarkupLMProcessor]]
```python
transformers.MarkupLMProcessor(feature_extractor, tokenizer)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/processing_markuplm.py#L25)
**Параметры:**
feature_extractor (`feature_extractor_class`) : Извлечение признаков является обязательным входом.
tokenizer (`MarkupLMTokenizer`) : Токенизатор является обязательным входным параметром.
Создаёт MarkupLMProcessor, который объединяет экстрактор признаков и токенизатор в единый процессор.
[MarkupLMProcessor](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMProcessor) предоставляет все возможности `feature_extractor_class` и [MarkupLMTokenizer](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer). Подробнее см. в `~feature_extractor_class` и [~MarkupLMTokenizer](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMTokenizer).
#### __call__[[transformers.MarkupLMProcessor.__call__]]
```python
__call__(html_strings = None, nodes = None, xpaths = None, node_labels = None, questions = None, add_special_tokens: bool = True, padding: bool | str | transformers.utils.generic.PaddingStrategy = False, truncation: bool | str | transformers.tokenization_utils_base.TruncationStrategy = None, max_length: int | None = None, stride: int = 0, pad_to_multiple_of: int | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/processing_markuplm.py#L31)
**Параметры:**
html_strings (`str` или `list[str]`, *необязательный*) : Исходные строки HTML для разбора и обработки. Если `parse_html=True` (по умолчанию), эти строки разбираются для автоматического извлечения узлов и xpaths. Если этот параметр указан, не следует передавать `nodes`, `xpaths` и `node_labels`. Обязателен, если `parse_html=True`.
nodes (`list[list[str]]`, *необязательный*) : Предварительно извлечённые HTML-узлы в виде списка списков, где каждый внутренний список содержит текстовое содержимое узлов для одного документа. Обязателен, если `parse_html=False`. Не должен указываться, если `parse_html=True`.
xpaths (`list[list[str]]`, *необязательный*) : Предварительно извлечённые выражения XPath, соответствующие узлам. Должно быть списком списков с той же структурой, что и `nodes`, где каждый XPath указывает расположение соответствующего узла в дереве HTML. Обязателен, если `parse_html=False`. Не должен указываться, если `parse_html=True`.
node_labels (`list[list[int]]`, *необязательный*) : Метки для узлов, как правило, используются для задач обучения или дообучения. Должно быть списком списков с той же структурой, что и `nodes`, где каждая метка соответствует узлу. Необязательный параметр, используется только при `parse_html=False`.
questions (`str` или `list[str]`, *необязательный*) : Строки с вопросами для задач вопросно-ответного типа. Если указаны, токенизатор обрабатывает вопросы как первую последовательность, а узлы — как вторую (text_pair). Если предоставлена одна строка, она преобразуется в список, чтобы соответствовать размерности батча распарсенного HTML.
add_special_tokens (`bool`, *необязательный*, по умолчанию `True`) : Указывает, следует ли добавлять специальные токены при кодировании последовательностей. Для этого используется базовая функция `PretrainedTokenizerBase.build_inputs_with_special_tokens`, которая определяет, какие токены автоматически добавляются к входным идентификаторам. Это полезно, если вы хотите автоматически добавлять токены `bos` или `eos`.
padding (bool, str or [PaddingStrategy](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.utils.PaddingStrategy), *optional*, по умолчанию `False`) : Включает и управляет выравниванием. Принимает следующие значения: - `True` или `'longest'`: Выравнивание до самой длинной последовательности в батче (или без выравнивания, если предоставлена только одна последовательность). - `'max_length'`: Выравнивание до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. - `False` или `'do_not_pad'` (по умолчанию): Без выравнивания (т. е. может выдать батч с последовательностями разной длины).
truncation (bool, str or [TruncationStrategy](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *optional*) : Включает и управляет усечением. Принимает следующие значения: - `True` или `'longest_first'`: Усечение до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Усечение выполняется посимвольно: если предоставлена пара последовательностей (или батч пар), то токен удаляется из самой длинной последовательности в паре. - `'only_first'`: Усечение до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или батч пар), усечение применяется только к первой последовательности пары. - `'only_second'`: Усечение до максимальной длины, указанной аргументом `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или батч пар), усечение применяется только ко второй последовательности пары. - `False` или `'do_not_truncate'` (по умолчанию): Усечение не выполняется (т.е. на выходе может быть батч с длинами последовательностей, превышающими максимально допустимый размер входа модели).
max_length (`int`, *optional*) : Управляет максимальной длиной, используемой одним из параметров усечения/дополнения. Если значение не задано или равно `None`, будет использована предопределённая максимальная длина модели, если один из параметров усечения/дополнения требует указания максимальной длины. Если у модели нет конкретной максимальной длины входных данных (как у XLNet), усечение/дополнение до максимальной длины будет отключено.
stride (`int`, *optional*, по умолчанию `0`) : Если задано число вместе с `max_length`, то переполненные токены, возвращаемые при `return_overflowing_tokens=True`, будут содержать некоторые токены из конца усечённой последовательности, чтобы обеспечить перекрытие между усечённой и переполненной последовательностями. Значение этого аргумента определяет количество перекрывающихся токенов.
pad_to_multiple_of (`int`, *optional*) : Если задано, последовательность будет дополнена до кратного указанного значения. Требуется активация `padding`. Это особенно полезно для использования Tensor Cores на аппаратных средствах NVIDIA с вычислительной способностью `>= 7.5` (Volta).
return_token_type_ids (`bool`, *необязательный*) : Указывает, следует ли возвращать идентификаторы типов токенов. Если значение не задано, идентификаторы типов токенов будут возвращены в соответствии со значением по умолчанию конкретного токенизатора, определяемым атрибутом `return_outputs`. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
return_attention_mask (`bool`, *необязательный*) : Указывает, следует ли возвращать маску внимания. Если значение не задано, маска внимания будет возвращена в соответствии со значением по умолчанию конкретного токенизатора, определяемым атрибутом `return_outputs`. [Что такое маски внимания?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *необязательный*, по умолчанию `False`) : Возвращать ли переполненные последовательности токенов. Если передана пара последовательностей входных идентификаторов (или батч пар) с `truncation_strategy = longest_first` или `True`, вместо возврата переполненных токенов будет выброшена ошибка.
return_special_tokens_mask (`bool`, *необязательный*, по умолчанию `False`) : Нужно ли возвращать информацию о маске специальных токенов.
return_offsets_mapping (`bool`, *необязательный*, по умолчанию `False`) : Возвращать или нет `(char_start, char_end)` для каждого токена. Это доступно только для быстрых токенизаторов, наследующихся от [PreTrainedTokenizerFast](/docs/transformers/v5.23.0/ru/main_classes/tokenizer#transformers.TokenizersBackend); при использовании токенизатора на Python этот метод вызовет `NotImplementedError`.
return_length (`bool`, *необязательный*, по умолчанию `False`) : Возвращать ли длины закодированных входных данных.
verbose (`bool`, *необязательный*, по умолчанию `True`) : Выводить ли дополнительную информацию и предупреждения.
return_tensors (`Union[str, ~utils.generic.TensorType]`, *необязательный*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
**Возвращает:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *необязательный*) -- Словарь списков/массивов/тензоров, возвращаемый методами `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask' и т. д.).
- **encoding** (`tokenizers.Encoding` или `Sequence[tokenizers.Encoding]`, *необязательный*) -- Если токенизатор является быстрым токенизатором, который выводит дополнительную информацию, например, отображение из пространства слов/символов в пространство токенов, то экземпляр `tokenizers.Encoding` или список экземпляров (для батчей) содержит эту информацию.
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
- **prepend_batch_axis** (`bool`, *необязательный*, по умолчанию `False`) — добавлять ли ось батча при преобразовании в тензоры (см. `tensor_type` выше). Обратите внимание, что этот параметр имеет значение, если параметр `tensor_type` задан, *иначе не влияет на результат*.
- **n_sequences** (`int`, *необязательный*) -- Количество входных последовательностей, представленных каждым кодированием (`None` для неизвестного значения, `1` для одной последовательности и `2` для пары последовательностей).
## MarkupLMModel[[transformers.MarkupLMModel]]
#### transformers.MarkupLMModel[[transformers.MarkupLMModel]]
```python
transformers.MarkupLMModel(config: MarkupLMConfig, add_pooling_layer = True)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L497)
**Параметры:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
add_pooling_layer (`bool`, *необязательный*, по умолчанию `True`) : Нужно ли добавлять слой пулинга
Модель Markuplm без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.MarkupLMModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, xpath_tags_seq: typing.Optional[torch.LongTensor] = None, xpath_subs_seq: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L521)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы тегов для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
xpath_subs_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы подстрок для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов сегментов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
position_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое position IDs?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) и входных данных.
Метод forward модели [MarkupLMModel](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoProcessor, MarkupLMModel
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = MarkupLMModel.from_pretrained("microsoft/markuplm-base")
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 4, 768]
```
## MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
#### transformers.MarkupLMForSequenceClassification[[transformers.MarkupLMForSequenceClassification]]
```python
transformers.MarkupLMForSequenceClassification(config: MarkupLMConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L802)
**Параметры:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
MarkupLM Модель transformer с головой для классификации/регрессии последовательности сверху (линейный слой поверх пуллинг-выхода), например, для задач GLUE.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.MarkupLMForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L819)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы тегов для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
xpath_subs_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы подстрок для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
position_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое идентификаторы позиций?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления функции потерь классификации/регрессии последовательности. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется функция потерь регрессии (среднеквадратичная ошибка), если `config.num_labels > 1` — функция потерь классификации (кросс-энтропия).
**Возвращает:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) или `tuple(torch.Tensor)`
Объект [SequenceClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) и входных данных.
Метод forward класса [MarkupLMForSequenceClassification](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMForSequenceClassification) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoProcessor, AutoModelForSequenceClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> model = AutoModelForSequenceClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> html_string = " Page Title "
>>> encoding = processor(html_string, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
#### transformers.MarkupLMForTokenClassification[[transformers.MarkupLMForTokenClassification]]
```python
transformers.MarkupLMForTokenClassification(config: MarkupLMConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L709)
**Параметры:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель MarkupLM с головой `token_classification` сверху.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.MarkupLMForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L725)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы тегов для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
xpath_subs_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы подстрок для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
position_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое идентификаторы позиций?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
labels (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Метки для вычисления функции потерь классификации токенов. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`.
**Возвращает:** [MaskedLMOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) или `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) и входных данных.
Метод forward класса [MarkupLMForTokenClassification](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMForTokenClassification) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери маскированного языкового моделирования (MLM).
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoProcessor, AutoModelForTokenClassification
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base")
>>> processor.parse_html = False
>>> model = AutoModelForTokenClassification.from_pretrained("microsoft/markuplm-base", num_labels=7)
>>> nodes = ["hello", "world"]
>>> xpaths = ["/html/body/div/li[1]/div/span", "/html/body/div/li[1]/div/span"]
>>> node_labels = [1, 2]
>>> encoding = processor(nodes=nodes, xpaths=xpaths, node_labels=node_labels, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
#### transformers.MarkupLMForQuestionAnswering[[transformers.MarkupLMForQuestionAnswering]]
```python
transformers.MarkupLMForQuestionAnswering(config: MarkupLMConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L603)
**Параметры:**
config ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Трансформер Markuplm со слоем классификации пропусков (span classification) для задач извлекающего вопросно-ответного взаимодействия, таких как SQuAD (линейный слой поверх выходных скрытых состояний для вычисления `span start logits` и `span end logits`).
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.MarkupLMForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, xpath_tags_seq: typing.Optional[torch.Tensor] = None, xpath_subs_seq: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/markuplm/modeling_markuplm.py#L615)
**Параметры:**
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
xpath_tags_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы тегов для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
xpath_subs_seq (`torch.LongTensor` формы `(batch_size, sequence_length, config.max_depth)`, *необязательный*) : Идентификаторы подстрок для каждого токена во входной последовательности, дополненные нулями до config.max_depth.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: - 0 соответствует токену *предложения A*, - 1 соответствует токену *предложения B*. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
position_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона `[0, config.n_positions - 1]`. [Что такое идентификаторы позиций?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательно*) : По желанию, вместо передачи `input_ids` можно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексы `input_ids` преобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели.
start_positions (`torch.Tensor` формы `(batch_size,)`, *необязательный*) : Метки для позиции (индекса) начала размеченного фрагмента для вычисления функции потерь классификации токенов. Позиции ограничиваются длиной последовательности (`sequence_length`). Позиции вне последовательности не учитываются при вычислении функции потерь.
end_positions (`torch.Tensor` формы `(batch_size,)`, *необязательный*) : Метки для позиции (индекса) конца размеченного фрагмента для вычисления функции потерь классификации токенов. Позиции ограничиваются длиной последовательности (`sequence_length`). Позиции вне последовательности не учитываются при вычислении функции потерь.
**Возвращает:** [QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) или `tuple(torch.Tensor)`
Объект [QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([MarkupLMConfig](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMConfig)) и входных данных.
Метод forward класса [MarkupLMForQuestionAnswering](/docs/transformers/v5.23.0/ru/model_doc/markuplm#transformers.MarkupLMForQuestionAnswering) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Суммарная функция потерь для извлечения пролёгов представляет собой сумму кросс-энтропии для начальных и конечных позиций.
- **start_logits** (`torch.Tensor` формы `(batch_size, sequence_length)`) -- Оценки начала пропусков (до SoftMax).
- **end_logits** (`torch.Tensor` формы `(batch_size, sequence_length)`) -- Оценки конца пролета (до SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoProcessor, MarkupLMForQuestionAnswering
>>> import torch
>>> processor = AutoProcessor.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> model = MarkupLMForQuestionAnswering.from_pretrained("microsoft/markuplm-base-finetuned-websrc")
>>> html_string = " My name is Niels "
>>> question = "What's his name?"
>>> encoding = processor(html_string, questions=question, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = encoding.input_ids[0, answer_start_index : answer_end_index + 1]
>>> processor.decode(predict_answer_tokens).strip()
'Niels'
```