
Transformers documentation
Optimización de LLMs para velocidad y memoria
Optimización de LLMs para velocidad y memoria
Los grandes modelos de lenguaje (LLM), como GPT3/4, Falcon y Llama, están avanzando rápidamente en su capacidad para abordar tareas centradas en el ser humano, consolidándose como herramientas esenciales en las industrias modernas basadas en el conocimiento. Sin embargo, desplegar estos modelos en tareas del mundo real sigue siendo un desafío:
- Para demostrar capacidades de comprensión y generación de texto cercanas a las humanas, los LLM actualmente deben estar compuestos por miles de millones de parámetros (véase Kaplan et al, Wei et. al). Esto amplifica en consecuencia las demandas de memoria para la inferencia.
- En muchas tareas del mundo real, los LLM necesitan recibir información contextual extensa. Esto requiere que el modelo sea capaz de gestionar secuencias de entrada muy largas durante la inferencia.
La clave de estos desafíos radica en aumentar las capacidades computacionales y de memoria de los LLM, especialmente al manejar secuencias de entrada extensas.
En esta guía, repasaremos las técnicas eficaces para la implementación eficiente de LLM:
Precisión reducida: La investigación ha demostrado que operar con una precisión numérica reducida, a saber, 8 bits y 4 bits, puede lograr ventajas computacionales sin una disminución considerable en el rendimiento del modelo.
Flash Attention: Flash Attention es una variación del algoritmo de atención que no solo ofrece un enfoque más eficiente en memoria, sino que también logra una mayor eficiencia gracias a la optimización del uso de la memoria de la GPU.
Innovaciones arquitectónicas: Dado que los LLM siempre se despliegan de la misma manera durante la inferencia, a saber, la generación de texto autoregresiva con un contexto de entrada largo, se han propuesto arquitecturas de modelos especializadas que permiten una inferencia más eficiente. Los avances más importantes en arquitecturas de modelos son Alibi, Rotary embeddings, Multi-Query Attention (MQA) y Grouped-Query-Attention (GQA).
A lo largo de esta guía, ofreceremos un análisis de la generación auto-regresiva desde la perspectiva de los tensores. Analizaremos las ventajas y desventajas de adoptar una precisión inferior, exploraremos de manera exhaustiva los algoritmos de atención más recientes y discutiremos arquitecturas de LLM mejoradas. Mientras lo hacemos, ejecutaremos ejemplos prácticos que muestran cada una de las mejoras de funcionalidad.
1. Menor precisión
Los requisitos de memoria de los LLM se comprenden mejor viendo el LLM como un conjunto de matrices y vectores de pesos y las entradas de texto como una secuencia de vectores. A continuación, la definición weights se utilizará para designar todas las matrices y vectores de pesos del modelo.
En el momento de redactar esta guía, los LLM constan de al menos un par de miles de millones de parámetros. Cada parámetro está compuesto por un número decimal, por ejemplo, 4.5689, que generalmente se almacena en formato float32, bfloat16 o float16. Esto nos permite calcular fácilmente la memoria necesaria para cargar el LLM en la memoria:
Cargar los pesos de un modelo con X mil millones de parámetros requiere aproximadamente 4 * X GB de VRAM en precisión float32
Hoy en día, sin embargo, los modelos rara vez se entrenan con precisión completa de float32, sino que generalmente se entrenan con precisión bfloat16 o, con menos frecuencia, con precisión float16. Por lo tanto, la regla general se convierte en:
Cargar los pesos de un modelo con X mil millones de parámetros requiere aproximadamente 2 * X GB de VRAM en precisión bfloat16/float16
Para entradas de texto más cortas (menos de 1024 tokens), el requisito de memoria para la inferencia está muy dominado por el requisito de memoria para cargar los pesos. Por lo tanto, por ahora, supongamos que el requisito de memoria para la inferencia es igual al requisito de memoria para cargar el modelo en la VRAM de la GPU.
Para dar algunos ejemplos de la cantidad aproximada de VRAM que se necesita para cargar un modelo en bfloat16:
- GPT3 requiere 2 * 175 GB = 350 GB de VRAM
- Bloom requiere 2 * 176 GB = 352 GB de VRAM
- Llama-2-70b requiere 2 * 70 GB = 140 GB de VRAM
- Falcon-40b requiere 2 * 40 GB = 80 GB de VRAM
- MPT-30b requiere 2 * 30 GB = 60 GB de VRAM
- bigcode/starcoder requiere 2 * 15.5 = 31 GB de VRAM
En el momento de redactar este documento, el chip de GPU más grande disponible en el mercado es el A100 & H100, que ofrece 80 GB de VRAM. La mayoría de los modelos enumerados anteriormente requieren más de 80 GB solo para ser cargados y, por lo tanto, necesitan necesariamente tensor parallelism y/o pipeline parallelism.
🤗 Transformers ahora admite el paralelismo de tensores para los modelos compatibles que tienen base_tp_plan en sus respectivas clases de configuración. Obtenga más información sobre el paralelismo de tensores aquí. Además, si le interesa escribir modelos de una manera compatible con el paralelismo de tensores, no dude en echar un vistazo a la biblioteca text-generation-inference.
La paralelización de pipeline ingenua se admite de forma nativa. Para ello, simplemente cargue el modelo con device="auto", lo que colocará automáticamente las diferentes capas en las GPU disponibles, tal como se explica aquí.
Tenga en cuenta, sin embargo, que, aunque es muy eficaz, esta paralelización de pipeline ingenua no aborda los problemas de inactividad de las GPU. Para ello se requiere una paralelización de pipeline más avanzada, tal como se explica aquí.
Si tienes acceso a un nodo de 8 x 80GB A100, podrías cargar BLOOM de la siguiente manera
!pip install transformers accelerate bitsandbytes optimum
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("bigscience/bloom", device_map="auto", pad_token_id=0)
Al usar device_map="auto", las capas de atención se distribuirían de manera equitativa entre todas las GPU disponibles.
En esta guía, utilizaremos bigcode/octocoder ya que puede ejecutarse en un solo dispositivo de GPU A100 de 40 GB. Tenga en cuenta que todas las optimizaciones de memoria y velocidad que aplicaremos a continuación son igualmente aplicables a modelos que requieren paralelismo de modelo o de tensor.
Dado que el modelo se carga en precisión bfloat16, usando nuestra regla general anterior, esperaríamos que el requisito de memoria para ejecutar la inferencia con bigcode/octocoder fuera de aproximadamente 31 GB de VRAM. Probémoslo.
Primero cargamos el modelo y el tokenizador y luego pasamos ambos al objeto pipeline de Transformers.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
import torch

model = AutoModelForCausalLM.from_pretrained("bigcode/octocoder", dtype=torch.bfloat16, device_map="auto", pad_token_id=0)
tokenizer = AutoTokenizer.from_pretrained("bigcode/octocoder")

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)prompt = "Question: Please write a function in Python that transforms bytes to Giga bytes.\n\nAnswer:"
result = pipe(prompt, max_new_tokens=60)[0]["generated_text"][len(prompt):]
resultSalida:
Here is a Python function that transforms bytes to Giga bytes:\n\n```python\ndef bytes_to_giga_bytes(bytes):\n return bytes / 1024 / 1024 / 1024\n```\n\nThis function takes a single
Genial, ahora podemos usar directamente el resultado para convertir bytes en Gigabytes.
def bytes_to_giga_bytes(bytes):
  return bytes / 1024 / 1024 / 1024
Llamemos a torch.accelerator.memory.max_memory_allocated para medir la asignación máxima de memoria del acelerador.
bytes_to_giga_bytes(torch.accelerator.max_memory_allocated())
Salida:
29.0260648727417
¡Bastante cerca de nuestro cálculo aproximado! Podemos ver que el número no es exactamente correcto, ya que pasar de bytes a kilobytes requiere una multiplicación por 1024 en lugar de 1000. Por lo tanto, la fórmula aproximada también puede entenderse como un cálculo de “como máximo X GB”. Tenga en cuenta que, si hubiéramos intentado ejecutar el modelo con precisión completa float32, se habrían requerido nada menos que 64 GB de VRAM.
Casi todos los modelos se entrenan hoy en día en bfloat16, no hay razón para ejecutar el modelo con precisión completa de float32 si tu GPU admite bfloat16. Float32 no ofrecerá mejores resultados de inferencia que la precisión utilizada para entrenar el modelo.
Si no está seguro del formato en el que se almacenan los pesos del modelo en el Hub, siempre puede consultar la configuración del punto de control bajo "dtype", por ejemplo aquí. Se recomienda establecer el modelo con el mismo tipo de precisión que el indicado en la configuración al cargarlo con from_pretrained(..., dtype=...), excepto cuando el tipo original es float32, en cuyo caso se puede utilizar tanto float16 como bfloat16 para la inferencia.
Definamos una función flush(...) para liberar toda la memoria asignada, de modo que podamos medir con precisión la memoria máxima asignada en la GPU.
del pipe
del model

import gc
import torch

def flush():
  gc.collect()
  torch.accelerator.empty_cache()
  torch.accelerator.reset_peak_memory_stats()
Llamémoslo ahora para el siguiente experimento.
flush()
Desde la biblioteca Accelerate, también puede utilizar un método de utilidad independiente del dispositivo llamado release_memory, que tiene en cuenta varios backends de hardware como XPU, MLU, NPU, MPS y más.
from accelerate.utils import release_memory
# ...

release_memory(model)
¿Y si tu GPU no tiene 32 GB de VRAM? Se ha demostrado que los pesos del modelo pueden cuantizarse a 8 bits o 4 bits sin una pérdida significativa de rendimiento (ver Dettmers et al.). El modelo puede cuantizarse incluso a 3 o 2 bits con una pérdida de rendimiento aceptable, como se muestra en el reciente artículo GPTQ 🤯.
Sin entrar en demasiados detalles, los esquemas de cuantización buscan reducir la precisión de los pesos mientras intentan mantener los resultados de inferencia del modelo lo más precisos posible (es decir, lo más cercanos posible a bfloat16).
Tenga en cuenta que la cuantización funciona especialmente bien para la generación de texto, ya que solo nos importa elegir el conjunto de tokens siguientes más probables y no nos preocupan realmente los valores exactos de la distribución de logit del token siguiente.
Lo único que importa es que la distribución de logit del token siguiente se mantenga aproximadamente igual para que una operación de argmax o topk dé los mismos resultados.
Existen diversas técnicas de cuantización, que no detallaremos aquí, pero en general, todas las técnicas de cuantización funcionan de la siguiente manera:
- Cuantice todos los pesos a la precisión objetivo
- Cargue los pesos cuantizados y pase la secuencia de entrada de vectores en precisión bfloat16
- Descomprimir dinámicamente los pesos a bfloat16 para realizar el cálculo con sus vectores de entrada en precisión bfloat16
En pocas palabras, esto significa que matriz de entradas-pesos multiplicaciones, con siendo la entradas, siendo una matriz de pesos y siendo la salida:
se cambian a
para cada multiplicación de matrices. La descuantización y la recuantización se realizan de forma secuencial para todas las matrices de pesos a medida que las entradas recorren el grafo de la red.
Por lo tanto, el tiempo de inferencia a menudo no se reduce al usar pesos cuantizados, sino que aumenta.
Suficiente teoría, ¡probémoslo! Para cuantizar los pesos con Transformers, debes asegurarte de que la biblioteca bitsandbytes esté instalada.
!pip install bitsandbytes
A continuación, podemos cargar modelos en cuantización de 8 bits simplemente añadiendo la bandera load_in_8bit=True a from_pretrained.
model = AutoModelForCausalLM.from_pretrained("bigcode/octocoder", quantization_config=BitsAndBytesConfig(load_in_8bit=True), pad_token_id=0)Ahora, volvamos a ejecutar nuestro ejemplo y midamos el uso de memoria.
pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

result = pipe(prompt, max_new_tokens=60)[0]["generated_text"][len(prompt):]
resultSalida:
Here is a Python function that transforms bytes to Giga bytes:\n\n```python\ndef bytes_to_giga_bytes(bytes):\n return bytes / 1024 / 1024 / 1024\n```\n\nThis function takes a single
Genial, estamos obteniendo el mismo resultado que antes, así que no hay pérdida de precisión. Veamos cuánta memoria se usó esta vez.
bytes_to_giga_bytes(torch.accelerator.max_memory_allocated())
Salida:
15.219234466552734
¡Mucho menos! Hemos bajado a poco más de 15 GB, por lo que podríamos ejecutar este modelo en GPUs de consumo como la 4090. Estamos viendo una mejora muy notable en la eficiencia de memoria y prácticamente ninguna degradación en la salida del modelo. Sin embargo, también podemos notar una ligera ralentización durante la inferencia.
Eliminamos los modelos y volvemos a liberar la memoria.
del model
del pipeflush()
Veamos qué consumo de memoria GPU pico ofrece la cuantización a 4 bits. Cuantizar el modelo a 4 bits se puede hacer con la misma API que antes, esta vez pasando load_in_4bit=True en lugar de load_in_8bit=True.
model = AutoModelForCausalLM.from_pretrained("bigcode/octocoder", quantization_config=BitsAndBytesConfig(load_in_4bit=True), pad_token_id=0)

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

result = pipe(prompt, max_new_tokens=60)[0]["generated_text"][len(prompt):]
resultSalida:
Here is a Python function that transforms bytes to Giga bytes:\n\n```\ndef bytes_to_gigabytes(bytes):\n return bytes / 1024 / 1024 / 1024\n```\n\nThis function takes a single argument
Estamos viendo casi el mismo texto de salida que antes, solo falta python justo antes del fragmento de código. Veamos cuánta memoria se requirió.
bytes_to_giga_bytes(torch.accelerator.max_memory_allocated())
Salida:
9.543574333190918
¡Solo 9,5 GB! Eso realmente no es mucho para un modelo de más de 15 mil millones de parámetros.
Aunque observamos una degradación muy leve en la precisión de nuestro modelo aquí, la cuantización de 4 bits puede llevar en la práctica a resultados diferentes en comparación con la cuantización de 8 bits o la inferencia completa en bfloat16. Corresponde al usuario probarlo.
También ten en cuenta que la inferencia aquí fue un poco más lenta en comparación con la cuantización de 8 bits, debido al método de cuantización más agresivo utilizado para la cuantización de 4 bits, lo que provoca que y tarden más durante la inferencia.
del model
del pipeflush()
En general, observamos que ejecutar OctoCoder con una precisión de 8 bits redujo la VRAM de GPU requerida de 32 GB a solo 15 GB, y ejecutar el modelo con una precisión de 4 bits redujo aún más la VRAM de GPU requerida a poco más de 9 GB.
La cuantización de 4 bits permite ejecutar el modelo en GPUs como RTX3090, V100 y T4, que son bastante accesibles para la mayoría de las personas.
Para obtener más información sobre la cuantización y ver cómo se pueden cuantizar modelos para que requieran aún menos memoria de VRAM de GPU que en 4 bits, recomendamos explorar la implementación de GPT-QModel.
Como conclusión, es importante recordar que la cuantización de modelos intercambia una mayor eficiencia de memoria por precisión y, en algunos casos, tiempo de inferencia.
Si la memoria de la GPU no es una limitación para su caso de uso, a menudo no hay necesidad de explorar la cuantización. Sin embargo, muchas GPUs simplemente no pueden ejecutar LLMs sin métodos de cuantización, y en ese caso, los esquemas de cuantización de 4 bits y 8 bits son herramientas extremadamente útiles.
Para obtener información de uso más detallada, recomendamos encarecidamente consultar la documentación de cuantización de Transformers. A continuación, veamos cómo podemos mejorar la eficiencia computacional y de memoria mediante el uso de mejores algoritmos y una arquitectura de modelo mejorada.
2. Flash Attention
Los LLM de mejor rendimiento actuales comparten, más o menos, la misma arquitectura fundamental, que consiste en capas de avance hacia adelante, capas de activación, capas de normalización por capa y, lo más importante, capas de autoatención.
Las capas de autoatención son fundamentales en los modelos de lenguaje de gran escala (LLM), ya que permiten al modelo comprender las relaciones contextuales entre los tokens de entrada. Sin embargo, el consumo máximo de memoria de GPU para las capas de autoatención crece de forma cuadrática tanto en complejidad de cómputo como de memoria con el número de tokens de entrada (también llamado longitud de secuencia) que denotamos a continuación como . Aunque esto no es realmente notable para secuencias de entrada más cortas (de hasta 1000 tokens de entrada), se convierte en un problema serio para secuencias de entrada más largas (alrededor de 16000 tokens de entrada).
Veamos más de cerca. La fórmula para calcular la salida de una capa de autoatención para una entrada de longitud es:
es, por lo tanto, la secuencia de entrada para la capa de atención. Las proyecciones y constarán cada una de vectores, lo que resulta en de tamaño .
Los LLM suelen tener múltiples cabezas de atención, por lo que realizan varios cálculos de autoatención en paralelo. Suponiendo que el LLM tiene 40 cabezas de atención y se ejecuta con precisión bfloat16, podemos calcular el requisito de memoria para almacenar las matrices como bytes. Para solo se necesitan alrededor de 50 MB de VRAM, sin embargo, para necesitaríamos 19 GB de VRAM, y para necesitaríamos casi 1 TB solo para almacenar las matrices.
En resumen, el algoritmo de autoatención por defecto se vuelve rápidamente prohibitivamente costoso en memoria para contextos de entrada grandes.
A medida que los LLM mejoran en la comprensión y generación de texto, se aplican a tareas cada vez más complejas. Si antes los modelos gestionaban la traducción o el resumen de unas pocas frases, ahora manejan páginas completas, lo que exige la capacidad de procesar longitudes de entrada extensas.
¿Cómo podemos eliminar los requisitos de memoria exorbitantes para longitudes de entrada grandes? Necesitamos una nueva forma de calcular el mecanismo de autoatención que elimine la matriz. Tri Dao et al. desarrollaron exactamente ese nuevo algoritmo y lo llamaron Flash Attention.
En pocas palabras, Flash Attention separa el cálculo y, en su lugar, calcula fragmentos más pequeños de la salida iterando sobre múltiples pasos de cálculo de softmax:
con y siendo algunas estadísticas de normalización softmax que deben recalcularse para cada y .
Tenga en cuenta que Flash Attention en su totalidad es un poco más complejo y se ha simplificado en gran medida aquí, ya que profundizar demasiado está fuera del alcance de esta guía. Se invita al lector a consultar el bien redactado artículo de Flash Attention para obtener más detalles.
La idea principal aquí es:
Al llevar un registro de las estadísticas de normalización de softmax y utilizando algunas matemáticas inteligentes, Flash Attention ofrece salidas numéricamente idénticas en comparación con la capa de autoatención predeterminada, con un costo de memoria que solo aumenta de forma lineal con .
Al observar la fórmula, uno diría intuitivamente que Flash Attention debe ser mucho más lento en comparación con la fórmula de autoatención predeterminada, ya que se necesita realizar más cálculos. De hecho, Flash Attention requiere más FLOPs que la atención normal, ya que las estadísticas de normalización del softmax deben recalcularse constantemente (consulte el artículo para más detalles si le interesa).
Sin embargo, Flash Attention es mucho más rápido en inferencia en comparación con la atención predeterminada, debido a su capacidad para reducir significativamente las demandas sobre la memoria de alta banda ancha más lenta de la GPU (VRAM), centrándose en cambio en la memoria en chip más rápida (SRAM).
En esencia, Flash Attention se asegura de que todas las operaciones intermedias de escritura y lectura se realicen utilizando la memoria on-chip SRAM rápida, en lugar de tener que acceder a la memoria VRAM más lenta para calcular el vector de salida .
En la práctica, actualmente no hay absolutamente ninguna razón para no usar Flash Attention si está disponible. El algoritmo produce matemáticamente las mismas salidas, y es tanto más rápido como más eficiente en memoria.
3. Innovaciones arquitectónicas
Hasta ahora hemos analizado cómo mejorar la eficiencia computacional y de memoria mediante:
- Casting de los pesos a un formato de menor precisión
- Reemplazar el algoritmo de autoatención con una versión más eficiente en memoria y cómputo
Ahora veamos cómo podemos modificar la arquitectura de un LLM para que sea lo más efectiva y eficiente posible en tareas que requieren entradas de texto largas, por ejemplo:
- Preguntas y respuestas aumentadas por recuperación,
- Resumen,
- Chat
Tenga en cuenta que chat no solo requiere que el LLM maneje entradas de texto largas, sino que también exige que el LLM sea capaz de manejar de manera eficiente el diálogo de ida y vuelta entre el usuario y el asistente (como ChatGPT).
Una vez entrenado, resulta difícil modificar la arquitectura fundamental del LLM, por lo que es importante hacer consideraciones sobre las tareas del LLM de antemano y optimizar la arquitectura del modelo en consecuencia. Hay dos componentes importantes de la arquitectura del modelo que se convierten rápidamente en cuellos de botella de memoria y/o rendimiento para secuencias de entrada grandes.
- Los embeddings posicionales
- La caché de clave-valor
Veamos cada componente en más detalle
3.1 Mejora de las incrustaciones posicionales de los LLM
La autoatención pone cada token en relación con los tokens de los demás. Por ejemplo, la matriz de la secuencia de entrada de texto “«Hello», «I», «love», «you» podría verse así:

Cada token de palabra recibe una masa de probabilidad con la que atiende a todos los demás tokens de palabra y, por lo tanto, se pone en relación con todos los demás tokens de palabra. Por ejemplo, la palabra “love” atiende a la palabra “Hello” con un 5%, a “I” con un 30% y a sí misma con un 65%.
Un LLM basado en autoatención, pero sin embeddings de posición, tendría grandes dificultades para comprender las posiciones de las entradas de texto entre sí. Esto se debe a que la puntuación de probabilidad calculada por relaciona cada token de palabra con cada otro token de palabra en computaciones, independientemente de su distancia posicional relativa entre sí. Por lo tanto, para un LLM sin embeddings de posición, cada token parece tener la misma distancia a todos los demás tokens, e.g. diferenciar entre “Hello I love you” y “You love I hello” sería muy desafiante.
Para que el LLM comprenda el orden de las oraciones, se necesita una pista adicional, que generalmente se aplica en forma de codificaciones posicionales (también llamadas incrustaciones posicionales). Las codificaciones posicionales codifican la posición de cada token en una representación numérica que el LLM puede aprovechar para comprender mejor el orden de las oraciones.
Los autores del Attention Is All You Need introdujeron incrustaciones posicionales sinusoidales . donde cada vector se calcula como una función sinusoidal de su posición . Las codificaciones posicionales se suman simplemente a los vectores de la secuencia de entrada = indicando así al modelo que aprenda mejor el orden de las oraciones.
En lugar de usar embeddings de posición fijos, otros (como Devlin et al.) usaron codificaciones posicionales aprendidas para las cuales los embeddings de posición se aprenden durante el entrenamiento.
Los embeddings de posición sinusoidales y aprendidos solían ser los métodos predominantes para codificar el orden de las oraciones en los LLM, pero se encontraron un par de problemas relacionados con estas codificaciones posicionales:
- Los embeddings de posición sinusoidales y los aprendidos son ambos embeddings de posición absoluta, i.e. es decir, codifican un embedding único para cada id de posición: . Como mostraron Huang et al. y Su et al., los embeddings de posición absoluta conducen a un rendimiento deficiente de los LLM con entradas de texto largo. Para entradas de texto largo, es ventajoso que el modelo aprenda la distancia posicional relativa que tienen los tokens de entrada entre sí, en lugar de su posición absoluta.
- Al usar embeddings de posición aprendidos, el LLM debe entrenarse con una longitud de entrada fija $N$, lo que dificulta la extrapolación a una longitud de entrada mayor que la utilizada durante el entrenamiento.
Recientemente, los incrustados posicionales relativos que pueden abordar los problemas mencionados anteriormente se han vuelto más populares, en particular:
Ambos RoPE y ALiBi argumentan que lo mejor es indicar al LLM el orden de las oraciones directamente en el algoritmo de autoatención, ya que es allí donde los tokens de palabras se relacionan entre sí. Más específicamente, el orden de las oraciones debe indicarse modificando el cálculo.
Sin entrar en demasiados detalles, RoPE señala que la información posicional puede codificarse en pares de consulta-clave, e.g. y rotando cada vector por un ángulo y respectivamente, con que describe la posición de la frase de cada vector:
por lo que representa una matriz de rotación. no se aprende durante el entrenamiento, sino que se fija en un valor predefinido que depende de la longitud máxima de la secuencia de entrada durante el entrenamiento.
De este modo, la puntuación de probabilidad entre y solo se ve afectada si y depende únicamente de la distancia relativa independientemente de las posiciones específicas de cada vector y .
RoPE se utiliza en varios de los LLM más importantes de hoy en día, como:
Como alternativa, ALiBi propone un esquema de codificación de posición relativa mucho más simple. La distancia relativa que tienen los tokens de entrada entre sí se añade como un entero negativo escalado por un valor predefinido m a cada entrada de consulta-clave de la matriz justo antes del cálculo del softmax.
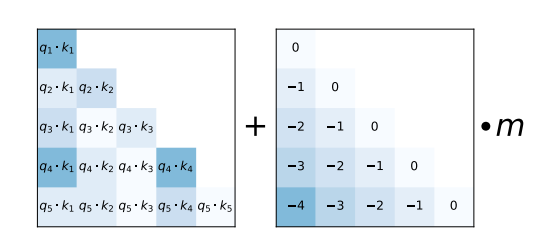
Como se muestra en el paper de ALiBi, esta codificación posicional relativa simple permite que el modelo mantenga un alto rendimiento incluso con secuencias de entrada de texto muy largas.
ALiBi se utiliza en varios de los LLM más importantes de hoy en día, como:
Ambos RoPE y ALiBi los codificadores de posición pueden extrapolar a longitudes de entrada no vistas durante el entrenamiento, mientras que se ha demostrado que la extrapolación funciona mucho mejor de forma predeterminada para ALiBi en comparación con RoPE. Para ALiBi, simplemente se aumentan los valores de la matriz de posición triangular inferior para que coincidan con la longitud de la secuencia de entrada. Para RoPE, mantener el mismo utilizado durante el entrenamiento produce malos resultados al pasar entradas de texto mucho más largas que las vistas durante el entrenamiento, c.f Press et al.. Sin embargo, la comunidad ha encontrado un par de trucos efectivos que adaptan $\theta$, lo que permite que RoPE los embeddings de posición funcionen bien para secuencias de entrada de texto extrapoladas (ver aquí).
RoPE y ALiBi son incrustaciones posicionales relativas que no se aprenden durante el entrenamiento, sino que se basan en las siguientes intuiciones:
- Las pistas posicionales sobre las entradas de texto deben proporcionarse directamente a la matriz de la capa de autoatención.
- El LLM debe incentivarse para aprender una codificación posicional de distancia relativa constante.
- A mayor distancia entre los tokens de entrada de texto, menor es la probabilidad de su consulta-valor. Tanto RoPE como ALiBi reducen la probabilidad de consulta-clave de tokens que están muy separados entre sí. RoPE la reduce disminuyendo su producto vectorial al aumentar el ángulo entre los vectores de consulta y clave. ALiBi la reduce sumando números negativos grandes al producto vectorial.
En conclusión, los LLM que se destinan a tareas que requieren procesar entradas de texto grandes se entrenan mejor con incrustaciones posicionales relativas, como RoPE y ALiBi. También ten en cuenta que, aunque un LLM con RoPE y ALiBi se haya entrenado solo con una longitud fija, por ejemplo puede seguir utilizándose en la práctica con entradas de texto mucho más grandes que $N_1$, como $N_2 = 8192 > N_1$, mediante la extrapolación de las incrustaciones posicionales.
3.2 La caché de clave-valor
La generación de texto auto-regresiva con LLMs funciona introduciendo de forma iterativa una secuencia de entrada, muestreando el siguiente token, añadiendo ese token a la secuencia de entrada y continuando así hasta que el LLM produzca un token que indique que la generación ha finalizado.
Eche un vistazo a Transformer’s Generate Text Tutorial para obtener una explicación más visual de cómo funciona la generación auto-regresiva.
Ejecutemos un fragmento de código rápido para mostrar cómo funciona la generación auto-regresiva en la práctica. Simplemente tomaremos el siguiente token más probable mediante torch.argmax.
input_ids = tokenizer(prompt, return_tensors="pt")["input_ids"].to(model.device)

for _ in range(5):
  next_logits = model(input_ids)["logits"][:, -1:]
  next_token_id = torch.argmax(next_logits,dim=-1)

  input_ids = torch.cat([input_ids, next_token_id], dim=-1)
  print("shape of input_ids", input_ids.shape)

generated_text = tokenizer.batch_decode(input_ids[:, -5:])
generated_textSalida:
shape of input_ids torch.Size([1, 21])
shape of input_ids torch.Size([1, 22])
shape of input_ids torch.Size([1, 23])
shape of input_ids torch.Size([1, 24])
shape of input_ids torch.Size([1, 25])
[' Here is a Python function']
Como podemos ver, cada vez aumentamos los tokens de entrada de texto con el token recién muestreado.
Con muy pocas excepciones, los LLM se entrenan utilizando el objetivo de modelado de lenguaje causal y, por lo tanto, enmascaran la matriz del triángulo superior de la puntuación de atención; por eso, en los dos diagramas anteriores, las puntuaciones de atención se dejan en blanco (es decir, tienen probabilidad 0). Para un repaso rápido del modelado de lenguaje causal, puede consultar el blog Illustrated Self Attention.
Como consecuencia, los tokens nunca dependen de tokens posteriores, más concretamente el vector nunca se relaciona con ningún vector de clave o valor si $j > i$. En su lugar, solo atiende a los vectores clave-valor anteriores $\mathbf{k}{m < i}, \mathbf{v}{m < i} \text{ , para } m \in {0, \ldots i - 1}$. Para reducir cálculos innecesarios, se puede almacenar en caché los vectores clave-valor de cada capa para todos los pasos de tiempo anteriores.
A continuación, indicaremos al LLM que utilice la caché de clave-valor recuperándola y reenviándola en cada pasada hacia adelante.
En Transformers, podemos recuperar la caché de clave-valor pasando la bandera use_cache a la llamada forward y luego pasarla junto con el token actual.
past_key_values = None # past_key_values is the key-value cache
generated_tokens = []
next_token_id = tokenizer(prompt, return_tensors="pt")["input_ids"].to(model.device)

for _ in range(5):
  next_logits, past_key_values = model(next_token_id, past_key_values=past_key_values, use_cache=True).to_tuple()
  next_logits = next_logits[:, -1:]
  next_token_id = torch.argmax(next_logits, dim=-1)

  print("shape of input_ids", next_token_id.shape)
  print("length of key-value cache", past_key_values.get_seq_length())  # past_key_values are of shape [num_layers, 0 for k, 1 for v, batch_size, length, hidden_dim]
  generated_tokens.append(next_token_id.item())

generated_text = tokenizer.batch_decode(generated_tokens)
generated_textSalida:
shape of input_ids torch.Size([1, 1])
length of key-value cache 20
shape of input_ids torch.Size([1, 1])
length of key-value cache 21
shape of input_ids torch.Size([1, 1])
length of key-value cache 22
shape of input_ids torch.Size([1, 1])
length of key-value cache 23
shape of input_ids torch.Size([1, 1])
length of key-value cache 24
[' Here', ' is', ' a', ' Python', ' function']
Como se puede observar, al usar la caché de clave-valor, los tokens de entrada de texto no aumentan en longitud, sino que permanecen como un único vector de entrada. Por otro lado, la longitud de la caché de clave-valor aumenta en uno en cada paso de decodificación.
Aprovechar la caché de clave-valor significa que el se reduce esencialmente a con siendo la proyección de consulta del token de entrada actual, que es siempre un único vector.
El uso de la caché de clave-valor tiene dos ventajas:
- Aumento significativo de la eficiencia computacional, ya que se realizan menos cálculos en comparación con el cálculo completo de la matriz . Esto conduce a un aumento en la velocidad de inferencia
- La memoria máxima requerida no aumenta de forma cuadrática con el número de tokens generados, sino que solo aumenta de forma lineal.
Se debe siempre hacer uso de la caché de clave-valor, ya que produce resultados idénticos y una aceleración significativa para secuencias de entrada más largas. Transformers tiene la caché de clave-valor habilitada de forma predeterminada al utilizar el pipeline de texto o el método
generate. Contamos con una guía completa dedicada a las cachés aquí.
Ten en cuenta que, a pesar de nuestra recomendación de usar cachés de clave-valor, la salida de tu LLM puede ser ligeramente diferente cuando los utilizas. Esta es una propiedad de los propios núcleos de multiplicación de matrices; puedes leer más al respecto aquí.
3.2.1 Conversación de varias rondas
La caché de clave-valor es especialmente útil para aplicaciones como el chat, donde se requieren múltiples pasadas de decodificación auto-regresiva. Veamos un ejemplo.
User: How many people live in France?
Assistant: Roughly 75 million people live in France
User: And how many are in Germany?
Assistant: Germany has ca. 81 million inhabitants
En este chat, el LLM ejecuta la decodificación auto-regresiva dos veces:
- La primera vez, la caché de claves y valores está vacía y el prompt de entrada es
"User: How many people live in France?"y el modelo genera de forma autoregresiva el texto"Roughly 75 million people live in France"mientras aumenta la caché de claves y valores en cada paso de decodificación. - La segunda vez, el prompt de entrada es
"User: How many people live in France? \n Assistant: Roughly 75 million people live in France \n User: And how many in Germany?". Gracias a la caché, todos los vectores clave-valor de las dos primeras oraciones ya están calculados. Por lo tanto, el prompt de entrada solo consiste en"User: And how many in Germany?". Mientras se procesa el prompt de entrada acortado, sus vectores clave-valor calculados se concatenan a la caché de clave-valor de la primera decodificación. La respuesta del segundo Asistente,"Germany has ca. 81 million inhabitants", se genera entonces de forma auto-regresiva con una caché de clave-valor que consiste en los vectores clave-valor codificados de"User: How many people live in France? \n Assistant: Roughly 75 million people live in France \n User: And how many are in Germany?".
Hay dos cosas que deben tenerse en cuenta aquí:
- Mantener todo el contexto es crucial para los LLM desplegados en chat para que el LLM comprenda todo el contexto previo de la conversación. Por ejemplo, en el ejemplo anterior, el LLM debe entender que el usuario se refiere a la población al preguntar
"And how many are in Germany". - La caché clave-valor es extremadamente útil para el chat, ya que nos permite hacer crecer continuamente el historial de chat codificado en lugar de tener que recodificar el historial de chat desde cero (como ocurriría, por ejemplo, al usar una arquitectura codificador-decodificador).
En transformers, una llamada a generate devolverá past_key_values cuando se pase return_dict_in_generate=True, además del valor predeterminado use_cache=True. Tenga en cuenta que aún no está disponible a través de la interfaz de pipeline.
# Generation as usual
prompt = system_prompt + "Question: Please write a function in Python that transforms bytes to Giga bytes.\n\nAnswer: Here"
model_inputs = tokenizer(prompt, return_tensors='pt')
generation_output = model.generate(**model_inputs, max_new_tokens=60, return_dict_in_generate=True)
decoded_output = tokenizer.batch_decode(generation_output.sequences)[0]

# Piping the returned `past_key_values` to speed up the next conversation round
prompt = decoded_output + "\nQuestion: How can I modify the function above to return Mega bytes instead?\n\nAnswer: Here"
model_inputs = tokenizer(prompt, return_tensors='pt')
generation_output = model.generate(
  **model_inputs,
  past_key_values=generation_output.past_key_values,
  max_new_tokens=60,
  return_dict_in_generate=True
)
tokenizer.batch_decode(generation_output.sequences)[0][len(prompt):]Salida:
 is a modified version of the function that returns Mega bytes instead.

def bytes_to_megabytes(bytes):
   return bytes / 1024 / 1024

Answer: The function takes a number of bytes as input and returns the number of
Genial, no se gasta tiempo adicional recalculando las mismas claves y valores para la capa de atención. Sin embargo, hay un inconveniente. Aunque la memoria pico necesaria para la matriz se reduce significativamente, mantener la caché de clave-valor en memoria puede resultar muy costoso en términos de memoria para secuencias de entrada largas o chats de varios turnos. Recuerda que la caché de clave-valor debe almacenar los vectores de clave-valor para todos los vectores de entrada anteriores en todas las capas de autoatención y para todas las cabezas de atención.
Calculemos el número de valores de coma flotante que deben almacenarse en la caché de clave-valor para el LLM bigcode/octocoder que usamos antes.
El número de valores de coma flotante equivale a dos veces la longitud de la secuencia, multiplicada por el número de cabezas de atención, por la dimensión de la cabeza de atención y por el número de capas.
Calcular esto para nuestro LLM con una longitud de secuencia de entrada hipotética de 16000 da:
config = model.config
2 * 16_000 * config.n_layer * config.n_head * config.n_embd // config.n_headSalida:
7864320000
¡Aproximadamente 8 mil millones de valores flotantes! Almacenar 8 mil millones de valores flotantes con precisión float16 requiere unos 15 GB de RAM, lo que equivale a aproximadamente la mitad del tamaño de los pesos del modelo.
Los investigadores han propuesto dos métodos que permiten reducir significativamente el coste de memoria del almacenamiento de la caché de claves y valores, que se exploran en las subsecciones siguientes.
3.2.2 Multi-Query-Attention (MQA)
Multi-Query-Attention fue propuesto en el artículo Fast Transformer Decoding: One Write-Head is All You Need de Noam Shazeer. Como indica el título, Noam descubrió que, en lugar de usar n_head pesos de proyección clave-valor, se puede usar un único par de pesos de proyección clave-valor compartido entre todas las cabezas de atención sin que el rendimiento del modelo se degrade significativamente.
Al utilizar un único par de pesos de proyección de clave-valor, los vectores de clave y valor deben ser idénticos en todas las cabezas de atención, lo que significa que solo necesitamos almacenar 1 par de proyección de clave-valor en la caché en lugar de
n_headpares.
Como la mayoría de los LLM utilizan entre 20 y 100 cabezas de atención, MQA reduce significativamente el consumo de memoria de la caché de clave-valor. Para el LLM utilizado en este notebook, podríamos reducir el consumo de memoria requerido de 15 GB a menos de 400 MB con una longitud de secuencia de entrada de 16000.
Además de los ahorros de memoria, MQA también conduce a una mayor eficiencia computacional, como se explica a continuación. En la decodificación autorregresiva, los grandes vectores clave-valor deben recargarse, concatenarse con el par de vectores clave-valor actual para luego introducirse en el cálculo en cada paso. En la decodificación autorregresiva, el ancho de banda de memoria requerido para la recarga constante puede convertirse en un cuello de botella temporal serio. Al reducir el tamaño de los vectores clave-valor, se necesita acceder a menos memoria, reduciendo así el cuello de botella de ancho de banda de memoria. Para más detalles, echa un vistazo a el papel de Noam.
La parte importante a entender aquí es que reducir el número de cabezas de atención clave-valor a 1 solo tiene sentido si se utiliza una caché de clave-valor. El consumo de memoria pico del modelo para una única pasada hacia adelante sin caché de clave-valor permanece sin cambios, ya que cada cabeza de atención aún tiene un vector de consulta único, por lo que cada cabeza de atención aún tiene un matriz.
MQA ha sido ampliamente adoptado por la comunidad y ahora lo utilizan muchos de los LLM más populares:
Además, el punto de control utilizado en este cuaderno - bigcode/octocoder - hace uso de MQA.
3.2.3 Grouped-Query-Attention (GQA)
Grouped-Query-Attention, propuesta por Ainslie et al. de Google, encontró que el uso de MQA a menudo puede provocar una degradación de la calidad en comparación con el uso de proyecciones multi-cabeza de clave-valor estándar. El paper argumenta que se puede mantener más rendimiento del modelo reduciendo de forma menos drástica el número de pesos de proyección de cabezas de consulta. En lugar de usar un solo peso de proyección de clave-valor, se deberían usar n < n_head pesos de proyección de clave-valor. Al elegir n con un valor significativamente menor que n_head, como 2, 4 u 8, se pueden mantener casi todas las ganancias de memoria y velocidad de MQA sacrificando menos capacidad del modelo y, por lo tanto, presumiblemente menos rendimiento.
Además, los autores de GQA descubrieron que los puntos de control de modelos existentes pueden actualizarse para tener una arquitectura GQA con tan solo el 5 % del cómputo de preentrenamiento original. Si bien el 5 % del cómputo de preentrenamiento original aún puede ser una cantidad masiva, el actualizado de GQA permite que los puntos de control existentes sean útiles para secuencias de entrada más largas.
GQA se propuso hace poco tiempo, por lo que, al momento de escribir este cuaderno, su adopción es menor. La aplicación más destacada de GQA es Llama-v2.
Como conclusión, se recomienda encarecidamente utilizar GQA o MQA si el LLM se despliega con decodificación auto-regresiva y debe manejar secuencias de entrada grandes, como es el caso, por ejemplo, del chat.
Conclusión
La comunidad de investigación está constantemente ideando nuevas y ingeniosas formas de acelerar el tiempo de inferencia para LLMs cada vez más grandes. Como ejemplo, una de las direcciones de investigación más prometedoras es la decodificación especulativa, donde los “tokens fáciles” son generados por modelos de lenguaje más pequeños y rápidos, y solo los “tokens difíciles” son generados por el propio LLM. Entrar en más detalle queda fuera del alcance de este cuaderno, pero puede leerse más al respecto en esta buena publicación de blog.
La razón por la que los LLM masivos como GPT3/4, Llama-2-70b, Claude y PaLM pueden ejecutarse tan rápidamente en interfaces de chat como Hugging Face Chat o ChatGPT se debe en gran parte a las mejoras mencionadas anteriormente en precisión, algoritmos y arquitectura. De cara al futuro, los aceleradores como GPUs, TPUs, etc… solo serán más rápidos y permitirán más memoria, pero aun así siempre se debe asegurarse de utilizar los mejores algoritmos y arquitecturas disponibles para obtener el máximo rendimiento por la inversión 🤗
Update on GitHub